जीनोम इंडिया और सटीक चिकित्सा: वादा बनाम आनुवंशिक डेटा की नैतिकता
Genome India ने 10,074 जीनोम और लाखों नए रूपांतरों से सटीक चिकित्सा का आधार बनाया, लेकिन निजता, भेदभाव, सामुदायिक सहमति और बराबर पहुँच के बचाव अधूरे हैं।
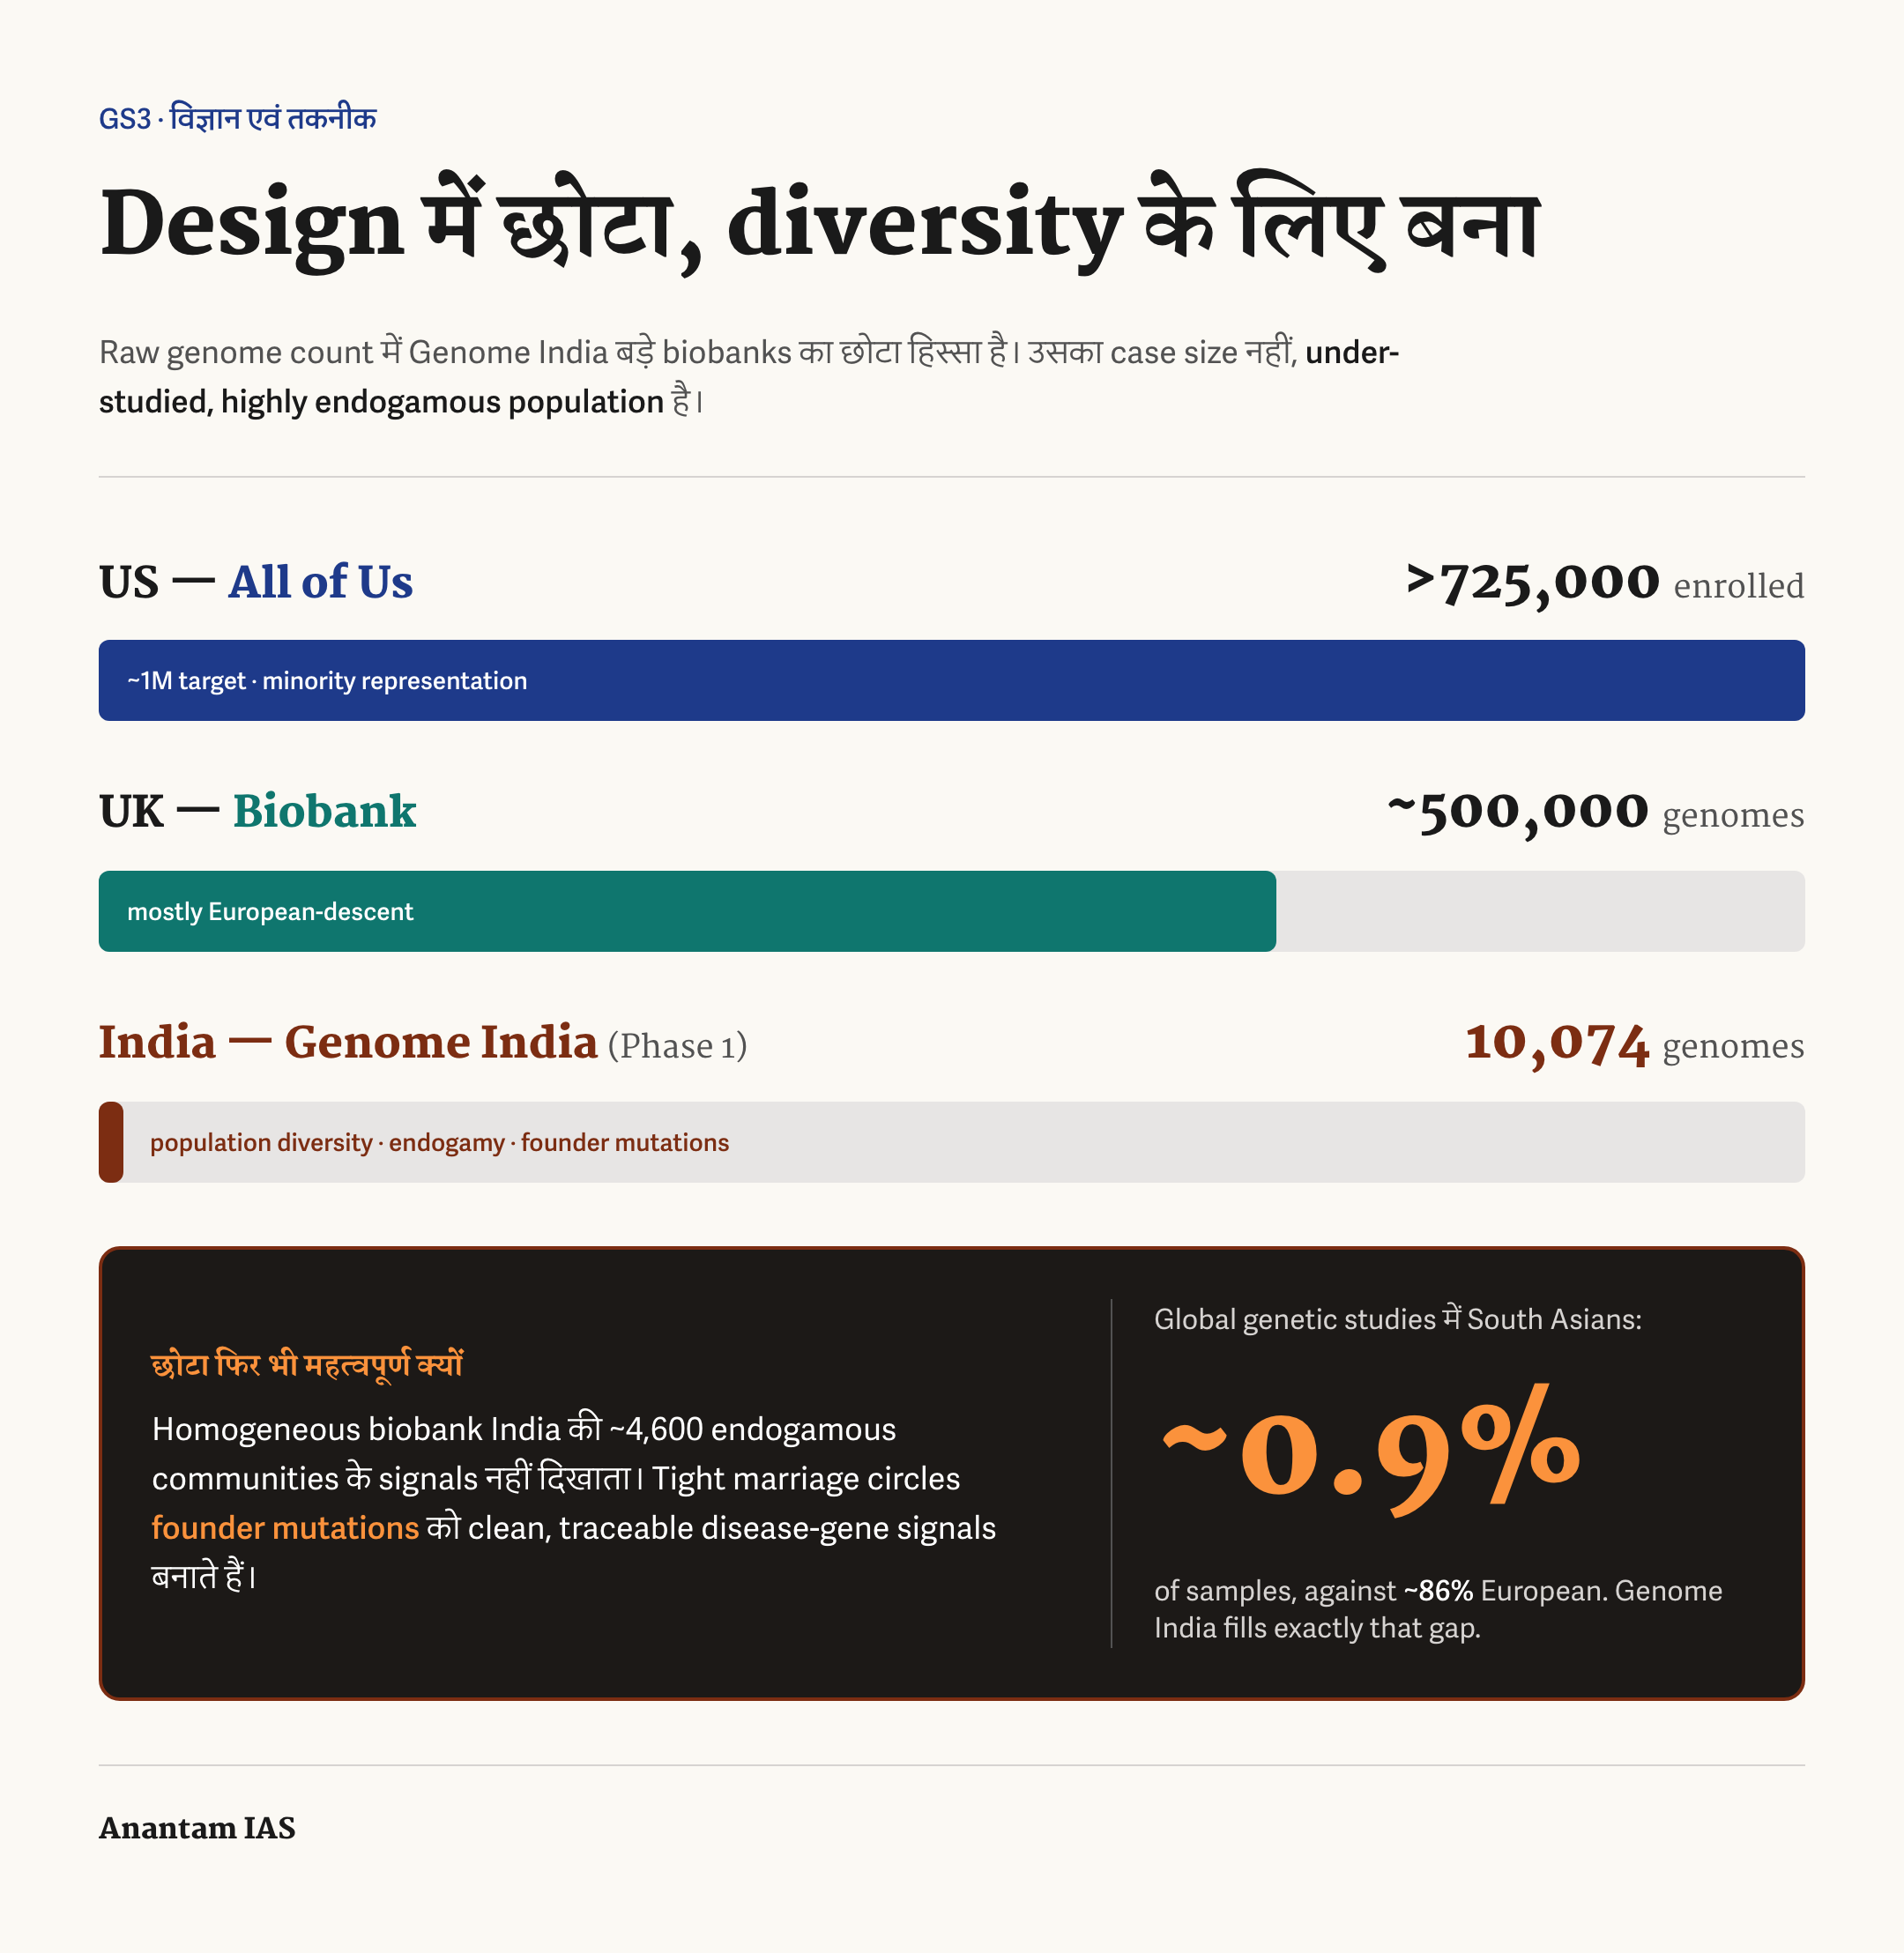
जीनोमिक्स के ज़्यादातर दौर में डॉक्टरों ने मानव DNA के जो नक्शे इस्तेमाल किए, वे लगभग पूरी तरह यूरोपीय शरीरों से बने थे। दुनिया के बड़े आनुवंशिक अध्ययनों में करीब 86% लोग यूरोपीय वंश के हैं, जबकि दक्षिण एशियाई 1% से भी कम। इसलिए चेन्नई का हृदय रोग विशेषज्ञ अंतरराष्ट्रीय डेटाबेस से जोखिम अंक लेता था तो उसका पैमाना मरीज़ जैसे शरीर पर कैलिब्रेट ही नहीं था। 9 जनवरी 2025 को यह बदलना शुरू हुआ। सरकार ने 10,000 से ज़्यादा भारतीयों के जीनोम वाला पहला Indian Genomic Data Set जारी किया और भारत व विदेश के शोधकर्ताओं के लिए खोला।
एक ही रिलीज़ वैज्ञानिक मील का पत्थर और शासन की समस्या दोनों है। विज्ञान का वादा भारतीय शरीरों के लिए सटीक चिकित्सा (precision medicine) है। समस्या यह है कि जीनोम नागरिक की सबसे निजी जानकारी है, भारत में आनुवंशिक भेदभाव रोकने वाला क़ानून नहीं और नया निजता क़ानून आनुवंशिक डेटा को खास श्रेणी भी नहीं मानता। इलाज और खुला असुरक्षित किनारा साथ आए।
मुद्दा क्या है?
बहस भारतीय जीनोम का अनुक्रम निकालने की ज़रूरत पर नहीं है। बहस इस पर है कि नुकसान आने के बाद नहीं, डेटा के साथ कौन-सा शासन पहले बनाया जाए। जीनोम कोशिकाओं में DNA के करीब 3 अरब रासायनिक अक्षरों में लिखी पूरी आनुवंशिक हिदायत है। पूर्ण-जीनोम अनुक्रमण (whole-genome sequencing) कुछ जगहें नहीं, पूरी हिदायत पढ़ती है। संदर्भ जीनोम (reference genome) मानक खाका है और उससे फ़र्क वाली जगह आनुवंशिक रूपांतर (genetic variant)। ज़्यादातर निरुपद्रव, कुछ बीमारी या दवा की प्रतिक्रिया बदलते हैं। सटीक चिकित्सा रोकथाम, निदान और इलाज को आनुवंशिक बनावट से मिलाती है। फार्माकोजीनोमिक्स (pharmacogenomics) देखता है कि जीन दवा की प्रतिक्रिया और खुराक कैसे बदलते हैं।
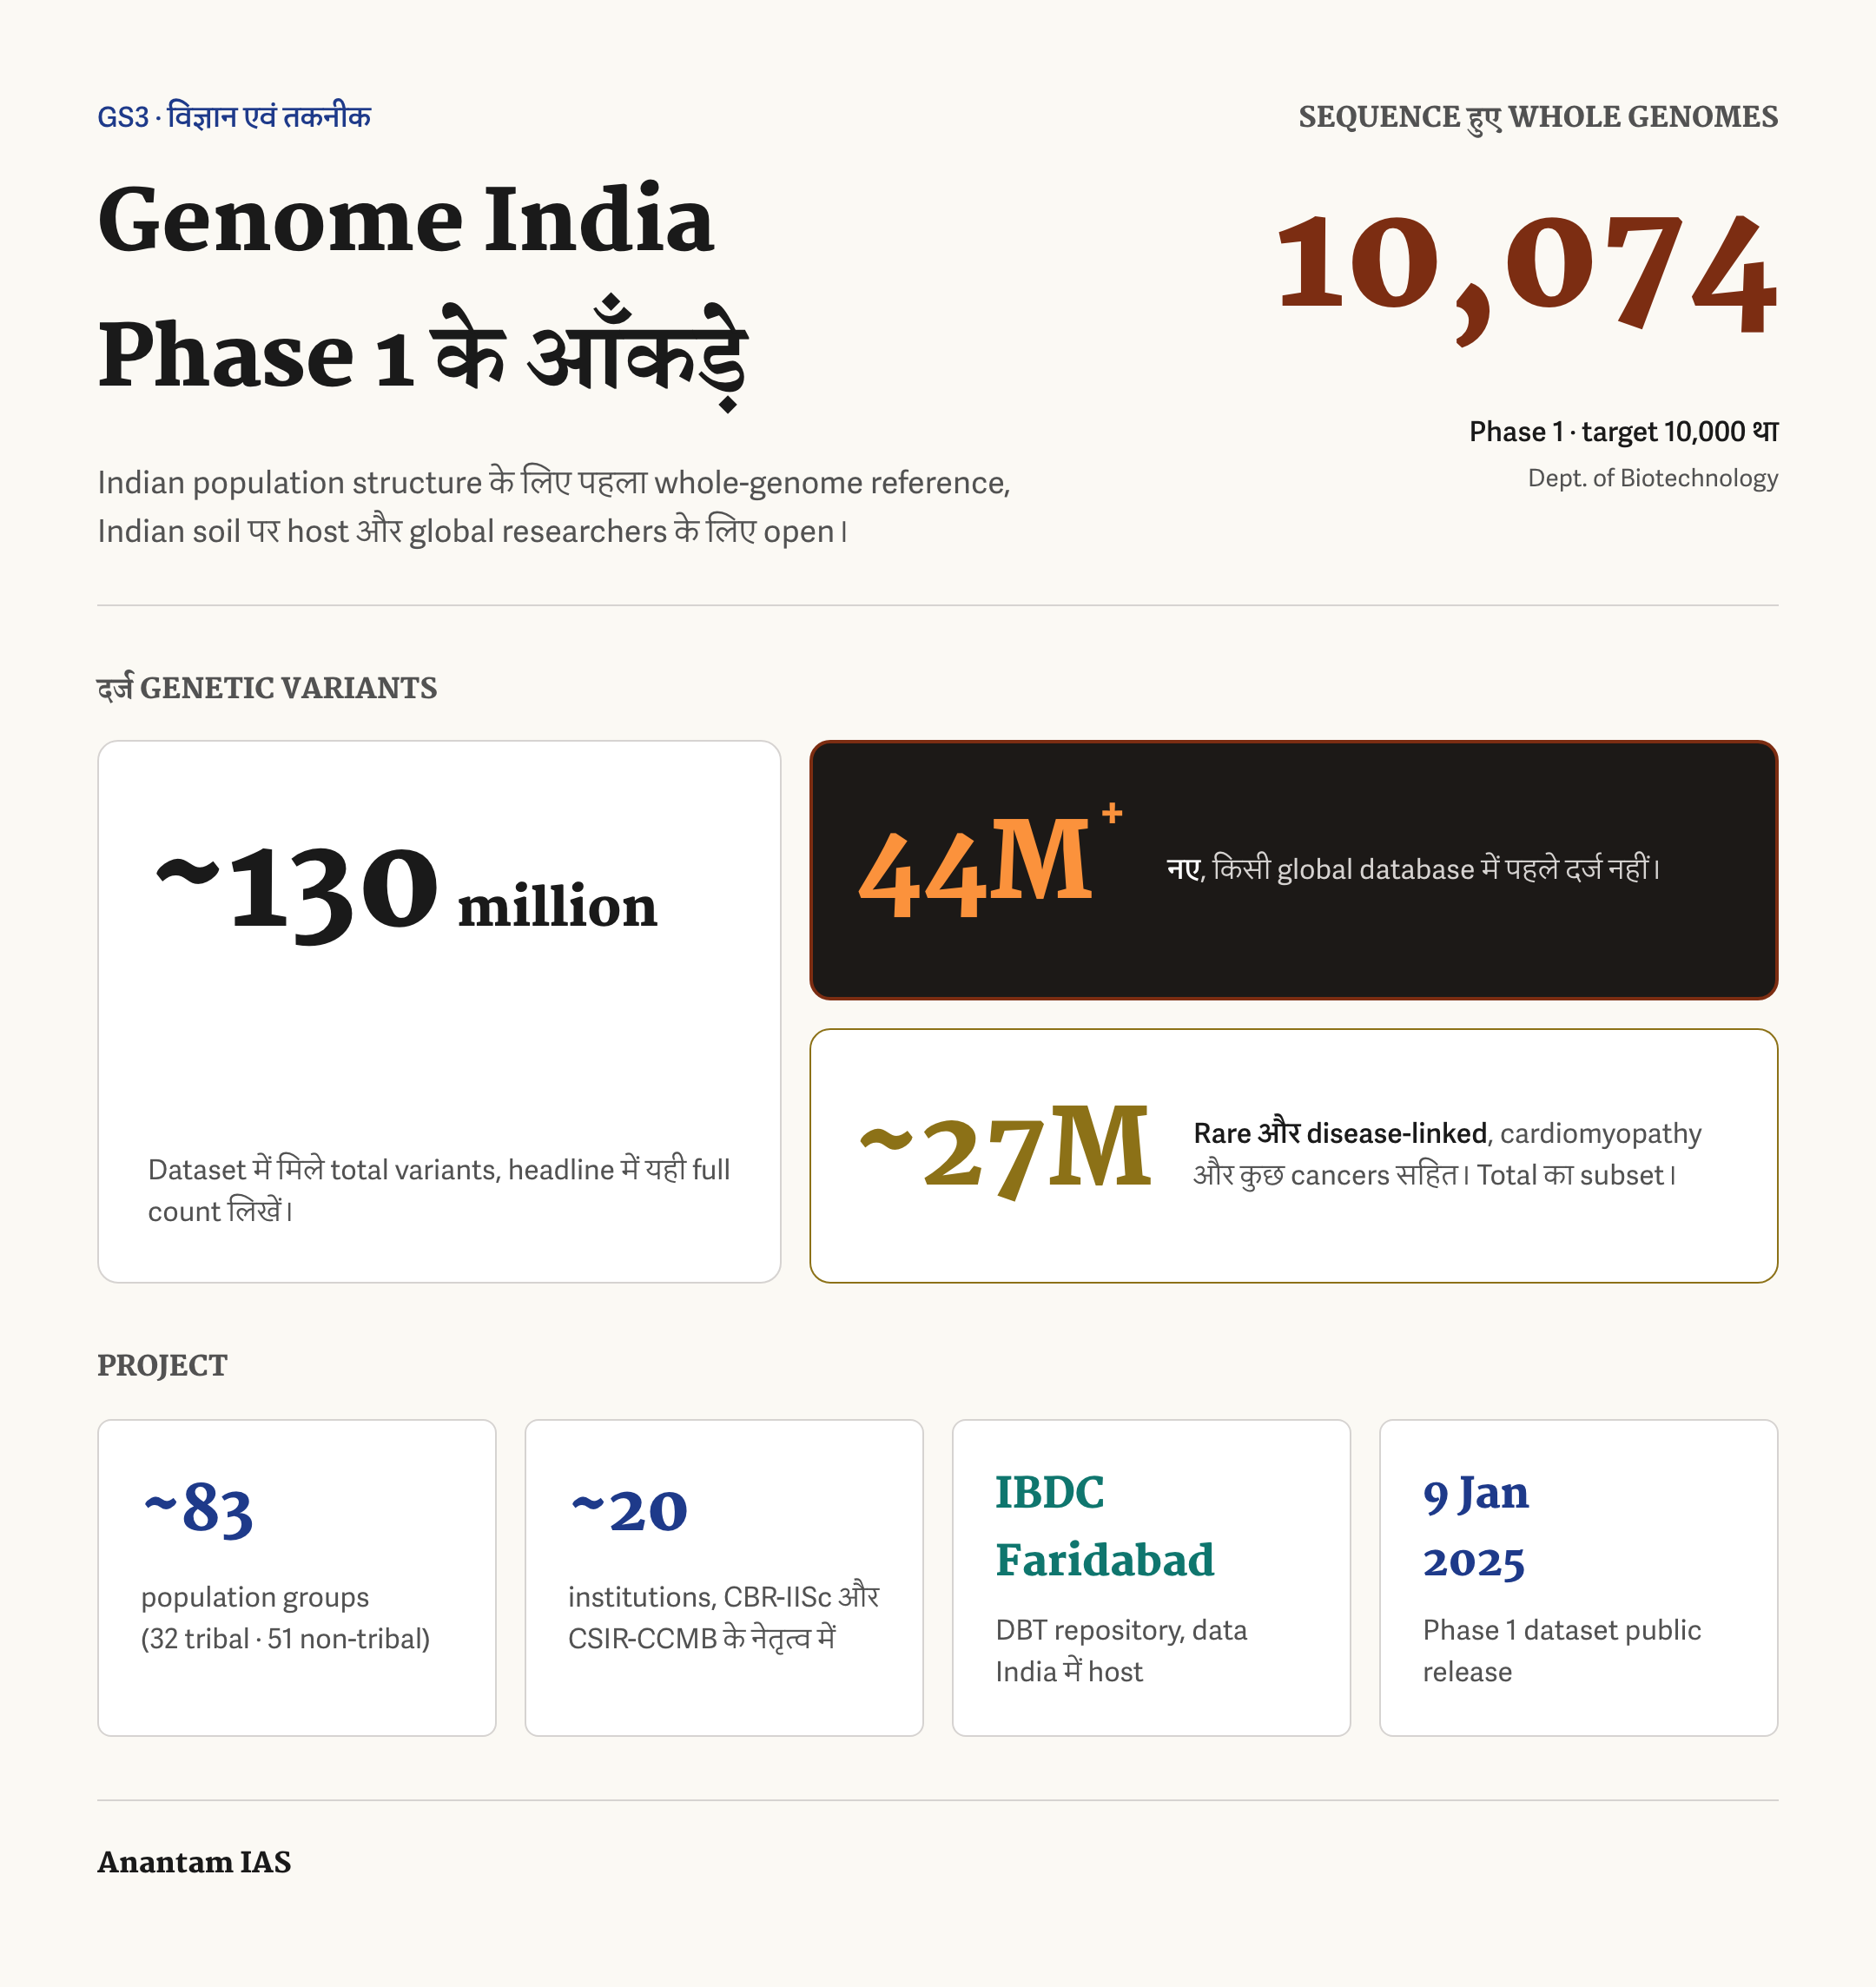
Genome India Project इसी मूल समस्या का जवाब है। Department of Biotechnology ने पैसा दिया, जनवरी 2020 में शुरू हुआ, करीब 20 संस्थानों ने चलाया, Centre for Brain Research at IISc बेंगलुरु और CSIR-CCMB हैदराबाद ने तालमेल किया। चरण 1 में करीब 83 आबादी समूहों से 10,074 पूर्ण जीनोम का अनुक्रम निकला और डेटासेट 9 जनवरी 2025 को सार्वजनिक हुआ।
जीनोम पासवर्ड नहीं जिसे चोरी के बाद बदल दें। वह जीवन भर तय, भाई-बहन और बच्चों से साझा, और बीमारी से पहले झुकाव बताता है। सवाल केवल डेटा क्या इलाज करेगा नहीं, बल्कि कौन देखेगा और उससे आपके साथ क्या कर सकता है। भारत ने पहला जवाब महत्वाकांक्षा से दिया, दूसरा लगभग खाली छोड़ा।
आँकड़े क्या बताते हैं?
चरण 1 में 10,074 पूर्ण जीनोम और करीब 20,000 रक्त नमूनों का बायोबैंक बना। नमूने करीब 36.7% ग्रामीण, 32.2% शहरी और 31.1% जनजातीय थे। शोधकर्ताओं ने करीब 13 करोड़ आनुवंशिक रूपांतर दर्ज किए। इनमें 4.4 करोड़ से ज़्यादा वैश्विक डेटाबेस में नए थे। करीब 2.7 करोड़ दुर्लभ और बीमारी से जुड़े रूपांतर थे, हाइपरकोलेस्ट्रोलेमिया, हाइपरट्रॉफिक कार्डियोमायोपैथी और कुछ कैंसर समेत; उनमें करीब 70 लाख दुर्लभ और विज्ञान के लिए नए दोनों थे। सही परतें हैं: 13 करोड़ कुल, 4.4 करोड़-से-ज़्यादा नए, 2.7 करोड़ दुर्लभ/बीमारी-संबंधी।
83 समूह, करीब 32 जनजातीय और 51 ग़ैर-जनजातीय, ऐसे देश से हैं जहाँ करीब 4,600 समुदाय और चार भाषा परिवार हैं। ऊँची अंतर्विवाह दर, कई पीढ़ियों तक समुदाय के भीतर शादी, संस्थापक उत्परिवर्तन (founder mutations) जमा करती है। परिवारों के लिए दुखद, शोध के लिए साफ़ बीमारी-जीन संकेत।
डेटा फरीदाबाद के Indian Biological Data Centre (IBDC), DBT के राष्ट्रीय जीवन-विज्ञान भंडार, में है। Biotech-PRIDE Guidelines 2021 और Framework for Exchange of Data के तहत गुमनाम रिलीज़ हुआ। नमूने विदेश भेजने के बजाय संप्रभु भारतीय होस्टिंग डेटा-संप्रभुता का ठोस अर्थ है।
परियोजना के पक्ष में तर्क
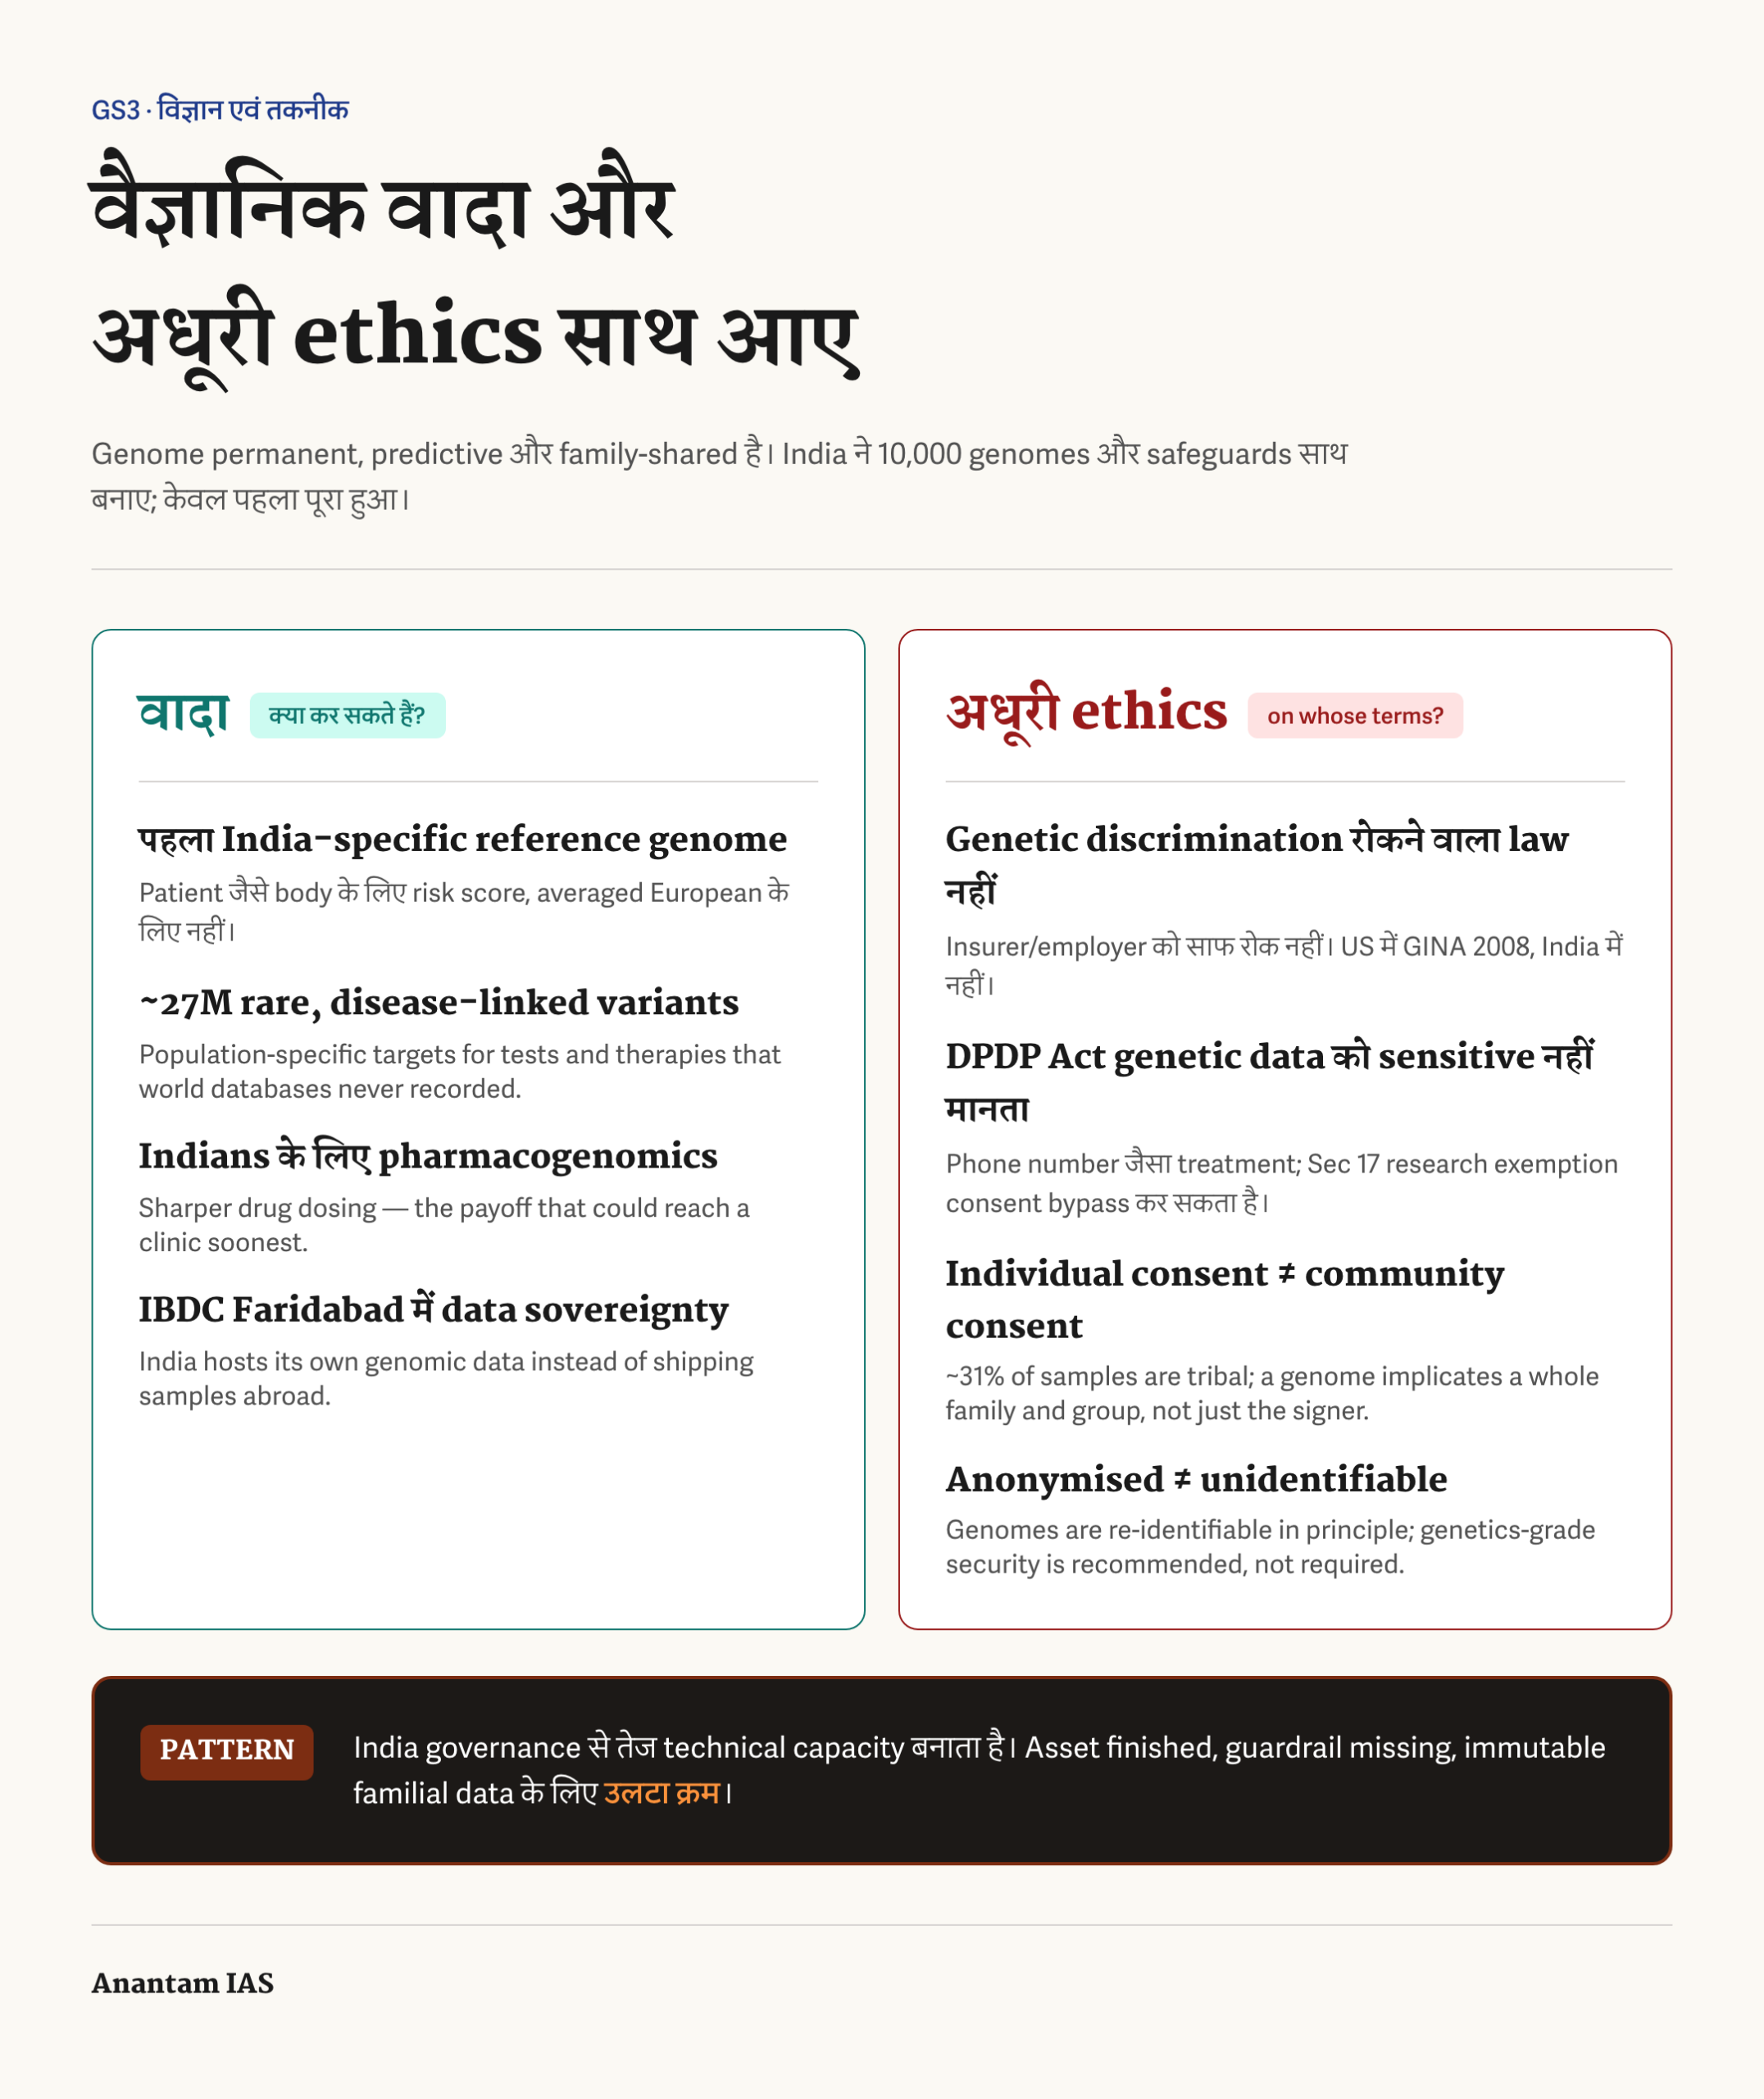
विज्ञान का वादा वास्तविक है। यह जीनोम में भारत की अदृश्यता खत्म करता है। यूरोपीय डेटा पर बने जोखिम अंक और दवा मॉडल भारतीयों पर ग़लत हो सकते हैं, क्योंकि एक आबादी में आम निरुपद्रव रूपांतर दूसरी में दुर्लभ खतरनाक हो सकता है। Genome India पहला संदर्भ पैनल है जो जानबूझकर भारतीय विविधता दिखाता है। इससे नैदानिक परीक्षण भारतीय मरीज़ को यूरोपीय औसत और त्रुटि की गुंजाइश की तरह नहीं, भारतीय मरीज़ की तरह पढ़ सकेगा।
परियोजना ने बीमारी की जीवविज्ञान दिखाई जिसे दुनिया ने नहीं देखा था। 2.7 करोड़ दुर्लभ, बीमारी से जुड़े रूपांतर भारतीय चिकित्सकों और शोधकर्ताओं को आबादी-विशेष निशाने देते हैं। जिस उत्परिवर्तन का रिकॉर्ड नहीं, उसके लिए परीक्षण या चिकित्सा नहीं बन सकती। अब हज़ारों संकेत नक्शे पर हैं।
नज़दीकी फ़ायदा फार्माकोजीनोमिक्स में है। दवा-चयापचय संदर्भ पैनल 60% से ज़्यादा यूरोपीय-वंश हैं, इसलिए ग़लत खुराक और विपरीत प्रतिक्रियाएँ भारतीय मरीज़ों पर चुपचाप लगने वाला बोझ हैं। भारतीय संदर्भ खुराक बेहतर कर सकता है, मनोरोग दवाओं समेत जहाँ लिखने से पहले आनुवंशिक जाँच का प्रमाण बढ़ रहा है। जीन-चिकित्सा की सुर्खियों से पहले क्लिनिक तक पहुँचने वाला फ़ायदा यही हो सकता है।
विविधता केवल टिक लगाने की बात नहीं, रणनीतिक खाई है। अंतर्विवाह और हज़ारों समूह संस्थापक उत्परिवर्तन व साफ़ बीमारी-जीन संकेत देते हैं जिन्हें एकरूप बायोबैंक नहीं दिखाता। विश्व मानक से छोटा डेटासेट उन आबादियों को पढ़ता है जिन्हें कोई नहीं पढ़ता, इसलिए बड़ा मूल्य दे सकता है। IBDC होस्टिंग भारत को नमूना-निर्यातक से शोध केंद्र बनाती है।
परियोजना के ख़िलाफ़ तर्क
जीनोम स्थायी, भविष्य बताने वाला और परिवार-साझा है, लेकिन 10,000 जीनोम साधारण-डेटा वाले क़ानूनी शून्य में आए। भारत में आनुवंशिक भेदभाव-रोधी क़ानून नहीं। USA ने 2008 में GINA बनाया; कनाडा, UK और ऑस्ट्रेलिया के अपने बचाव हैं। भारतीय क़ानून बीमाकर्ता या नियोक्ता को झुकाव के आधार पर कवर या नौकरी रोकने से साफ़ नहीं रोकता।
दिल्ली उच्च न्यायालय ने 2018 के Jai Prakash Tayal v. United India Insurance में “आनुवंशिक विकारों” को स्वास्थ्य कवर से व्यापक रूप से बाहर करना भेदभावपूर्ण और अनुच्छेद 14 की समानता के ख़िलाफ़ कहा। सर्वोच्च न्यायालय ने फैसले को आंशिक रोक दिया, इसलिए सुरक्षा स्थापित क़ानून नहीं।
Digital Personal Data Protection Act, 2023 और 2025 नियम आनुवंशिक डेटा को अलग संवेदनशील श्रेणी नहीं मानते। जीनोम फ़ोन नंबर वाले साधारण निजी-डेटा डब्बे में है। धारा 17 की व्यापक शोध छूट सहमति की ज़रूरतों को बाईपास कर सकती है। उल्लंघन पर ₹250 करोड़ जुर्माना डेटा को आनुवंशिकी-स्तर की खास सुरक्षा देने के बराबर नहीं।
जनजातीय और मूलनिवासी सहमति ढाँचे से मुश्किल है। नमूनों में करीब 31% जनजातीय हैं, लेकिन जीनोम पूरे परिवार और समुदाय को घेरता है। मानक सामुदायिक/सामूहिक सहमति और लाभ-बाँट होना चाहिए। DPDP शोध छूट व्यक्तिगत सहमति भी बाईपास कर सकती है, सामूहिक की बात दूर। ग़लत शासन कम अध्ययन किए गए लोगों को शामिल करने के नाम पर कमज़ोर समूहों से खींच लेना बन सकती है।
गुमनाम का अर्थ पहचान-रहित नहीं। जीनोम सिद्धांत में फिर-पहचान किए जा सकते हैं और ढाँचा वैश्विक शोधकर्ताओं को पहुँच देता है। ISO 27799 और 27789-शैली सुरक्षा सिफ़ारिश है, अनिवार्य नहीं। नैदानिक वादा भी सुर्खियों से दूर है। चरण 1 स्वस्थ असंबंधित स्वयंसेवकों का संदर्भ है, मरीज़ का इलाज नहीं। ग़ैर-विशेषज्ञ डॉक्टर जीनोमिक रिपोर्ट नहीं पढ़ पाते, जटिल-बीमारी रूपांतर अक्सर साफ़ कार्रवाई नहीं देते और सटीक चिकित्सा पहले महानगरों व अमीरों तक पहुँच सकती है।
गहरी संरचनात्मक तस्वीर
भारत शासन से तेज़ विश्व-स्तर की तकनीकी क्षमता बनाता है। विज्ञान जनवरी 2020 से तय योजना पर चली, 2025 में पूरी हुई और संप्रभु बुनियादी ढाँचे पर होस्ट हुई। बचाव के लिए बराबर योजना नहीं थी। परियोजना के साथ आनुवंशिक भेदभाव-रोधी विधेयक नहीं आया। निजता क़ानून ने आनुवंशिक डेटा को खास नहीं माना। Tayal सुरक्षा आंशिक रोक में है। संपत्ति बन गई, रेलिंग गायब, जबकि आनुवंशिक स्थायित्व इसे उलटा क्रम बनाती है।
2017 के K.S. Puttaswamy में सर्वोच्च न्यायालय ने अनुच्छेद 21 की निजता को मौलिक अधिकार माना। आनुवंशिक निजता इसका सबसे तीखा रूप है क्योंकि डेटा अपरिवर्तनीय और पारिवारिक है। Puttaswamy निजता और Tayal अनुच्छेद 14 समानता साथ पढ़ें: आनुवंशिक डेटा निजता और भेदभाव के चौराहे पर है, लेकिन जीन-विशेष लागू क़ानून नहीं। अधिकार सिद्धांत में हैं, मशीनरी नहीं।
विविधता वाली पिच असली है, लेकिन नमूना शामिल होना और लाभ शामिल होना अलग हैं। योगदान देने वाले समुदाय निजता का जोखिम उठाएँ और चिकित्साएँ महानगरों की क़ीमत पर रहें तो परियोजना हाशिए से इकट्ठा करके केंद्र को देगी। समानता विज्ञान का फ़ुटनोट नहीं, भरोसे की कसौटी है। क्षमता बनाना प्रतिनिधित्व और आत्मनिर्भरता है; बचाव संयम और अधिकार हैं। भारत पहली तरह की परियोजना में तेज़, दूसरी में धीमा है। यही सबक AI और डिजिटल पहचान तक जाता है।
क्या किया जाना चाहिए?
- आनुवंशिक भेदभाव-रोधी क़ानून बनाएँ। GINA शैली का क़ानून बीमा और रोज़गार में आनुवंशिक जानकारी का इस्तेमाल रोके और जीन पर निजता का सिद्धांत क़ानून में लिखे।
- आनुवंशिक डेटा को संवेदनशील निजी डेटा बनाएँ। DPDP ढाँचे में अलग सुरक्षित परत और धारा 17 शोध छूट को जीनोमिक सहमति के लिए सँकरा करें। जीनोम फ़ोन नंबर नहीं।
- समुदायों के लिए सहमति और शासन बनाएँ। जनजातीय/मूलनिवासी समूहों में सामूहिक सहमति, लाभ-बाँट और पहुँच देखने वाला स्वतंत्र जीनोमिक-डेटा नैतिकता निकाय हो।
- IBDC पर आनुवंशिकी-स्तर सुरक्षा अनिवार्य करें। ISO 27799/27789 नियंत्रण, ऑडिट पगडंडियाँ और परतदार/संघीय पहुँच क़ानूनी फ़र्श हों। फिर-पहचान योग्य गुमनाम डेटा को पहचाने गए डेटा जैसी सुरक्षा मिले।
- बराबर नैदानिक अनुवाद में निवेश करें। ग़ैर-विशेषज्ञ चिकित्सकों को प्रशिक्षित करें, सार्वजनिक निदान को पैसा दें, क़ीमत नियंत्रण और बीमा से चिकित्साएँ महानगरों के बाहर पहुँचाएँ।
- दस लाख जीनोम की महत्वाकांक्षा शासन की रफ़्तार पर बढ़ाएँ। कम प्रतिनिधित्व वाले समूह और बीमारी समूह जोड़ें, लेकिन सहमति, सुरक्षा और निगरानी क्षमता से तेज़ अनुक्रमण न करें।
ये विज्ञान को रोकते नहीं, मज़बूत करते हैं। नागरिकों को भरोसा हो कि जीनोम उनके ख़िलाफ़ नहीं जाएगा तो ज़्यादा लोग जुड़ेंगे। सटीक चिकित्सा का असली बुनियादी ढाँचा भरोसा है।
मुख्य परीक्षा के उत्तर में इसका इस्तेमाल
यह ऊँचे मूल्य वाला GS3 विषय है, साफ़ GS2 रीढ़ के साथ। GS3 में विज्ञान-तकनीक विकास, रोज़मर्रा के प्रयोग, जैव प्रौद्योगिकी, स्वदेशीकरण और डेटा संप्रभुता। GS2 में शासन/नियमन, अनुच्छेद 21 निजता, अनुच्छेद 14 समानता, कमज़ोर वर्ग और स्वास्थ्य शासन।
संभावित प्रश्न:
- Genome India Project वैज्ञानिक मील का पत्थर है, लेकिन आनुवंशिक-डेटा शासन साथ नहीं बढ़ा। आलोचनात्मक परीक्षण कीजिए।
- सटीक चिकित्सा आबादी-विशेष स्वास्थ्य सेवा का वादा करती है, लेकिन आनुवंशिक निजता और भेदभाव के गंभीर प्रश्न उठाती है। भारतीय संदर्भ में चर्चा कीजिए।
- नियामक बचाव से आगे वैज्ञानिक क्षमता बनाना भारतीय तकनीक मिशनों की बार-बार आने वाली विशेषता है। जीनोमिक डेटा के संदर्भ में विश्लेषण कीजिए।
उत्तर में लिखने लायक आँकड़े:
- चरण 1 में 10,074 पूर्ण जीनोम; डेटासेट 9 जनवरी 2025 को जारी।
- करीब 13 करोड़ कुल रूपांतर; 4.4 करोड़-से-ज़्यादा नए; करीब 2.7 करोड़ दुर्लभ/बीमारी से जुड़े।
- करीब 83 आबादी समूह, ऐसे देश से जहाँ करीब 4,600 समुदाय और चार भाषा परिवार हैं।
- वैश्विक अध्ययनों में दक्षिण एशियाई करीब 0.9% और यूरोपीय करीब 86%।
- UK Biobank करीब 5,00,000 जीनोम; USA की All of Us में 7,25,000 से ज़्यादा नामांकित; Genome India कच्चे पैमाने में करीब 50 गुना छोटा, विविधता-पहले।
- भारत में आनुवंशिक भेदभाव-रोधी क़ानून नहीं; USA के GINA 2008 समेत कनाडा, UK और ऑस्ट्रेलिया बचाव रखते हैं।
- DPDP Act 2023 आनुवंशिक डेटा को संवेदनशील नहीं मानता; उल्लंघन जुर्माना ₹250 करोड़ तक।
- दिल्ली उच्च न्यायालय Tayal 2018 ने आनुवंशिक बीमा बहिष्कार को अनुच्छेद 14 के ख़िलाफ़ कहा; सर्वोच्च न्यायालय ने आंशिक रोक लगाई।
मुख्य शब्द: पूर्ण-जीनोम अनुक्रमण, सटीक चिकित्सा, फार्माकोजीनोमिक्स, संदर्भ जीनोम, संस्थापक उत्परिवर्तन, अंतर्विवाह, आनुवंशिक निजता, सामुदायिक सहमति, डेटा संप्रभुता, फिर-पहचान, नैदानिक अनुवाद और स्वास्थ्य समानता।
संतुलित निष्कर्ष: जीनोम बैंक उतना ही क़ीमती है जितना भरोसा कमाता है। भारत ने सटीक चिकित्सा का विज्ञान उन बचावों से पहले बनाया जो उसे सुरक्षित बनाते हैं; इस फ़ासले को बंद करना परियोजना का कठिन और ज़्यादा महत्वपूर्ण आधा है।
उत्तर कैसे बनाएँ?
फ़ासले से शुरू करें: भारत ने 10,000 जीनोम और उन्हें बचाने वाले बचाव एक ही खिड़की में बनाए, लेकिन केवल पहला पूरा हुआ। दूसरी पंक्ति में जीनोम/सटीक चिकित्सा परिभाषित करें। शुरुआती भाग में 10,074 जीनोम, 13 करोड़ रूपांतर में 4.4 करोड़-से-ज़्यादा नए और वैश्विक नमूनों में दक्षिण एशियाई 1% से कम रखें। हर संख्या का मतलब बताएँ।
शासन की आलोचना से पहले विज्ञान को मज़बूत बनाकर रखें: असली संदर्भ मील का पत्थर, असली विविधता संपत्ति और नज़दीकी फार्माकोजीनोमिक्स। फिर गायब क़ानून रखें। सुधारों को भेदभाव-रोधी क़ानून, संवेदनशील-डेटा वर्गीकरण, सामुदायिक सहमति, आनुवंशिकी-स्तर सुरक्षा और बराबर अनुवाद में बाँटें। संस्थापक उत्परिवर्तन, अंतर्विवाह और फिर-पहचान जैसे शब्द इस्तेमाल करें।
आम गलतियाँ
- ग़लत संख्या न लिखें। 13 करोड़ कुल, 4.4 करोड़-से-ज़्यादा नए और 2.7 करोड़ दुर्लभ। बिना आधार के “36 लाख” न लें।
- परियोजना को शुद्ध सफलता या घोटाला न बनाएँ। विज्ञान और शासन का फ़ासला दोनों असली हैं।
- गुमनाम को सुरक्षित न मानें। जीनोम फिर-पहचान हो सकता है।
- परिवार न भूलें। रिश्तेदारों ने सहमति नहीं दी, फिर भी आनुवंशिक डेटा उन्हें घेरता है; जनजातीय समूह में व्यक्तिगत सहमति काफ़ी नहीं।
- नारे पर खत्म न करें। क्षमता-बनाम-शासन सबक या संवैधानिक मूल्य पर बंद करें।
उत्तर की छोटी रीढ़
- परिचय: मील का पत्थर बनाम गायब बचाव; अगली पंक्ति में जीनोम/सटीक चिकित्सा।
- प्रमाण: विविधता का अंधा धब्बा और नए रूपांतरों के दो-तीन स्रोत सहित आँकड़े।
- तर्क: संदर्भ पैनल/फार्माकोजीनोमिक्स का वादा, फिर भेदभाव-रोधी क़ानून, DPDP की चुप्पी, सहमति और फिर-पहचान।
- निदान: क्षमता शासन से आगे; अनुच्छेद 21 निजता और अनुच्छेद 14 समानता के पीछे जीन-विशेष क़ानून नहीं।
- आगे: संसद, DPDP व्यवस्था, नैतिकता निकाय, IBDC और स्वास्थ्य तंत्र के कर्ताओं के साथ सुधार।
- निष्कर्ष: प्रश्न के ठीक शब्दों में संतुलित पंक्ति।
आरेख या फ़्लोचार्ट का विचार
15-अंक श्रृंखला: यूरोपीय-झुके डेटाबेस → भारतीय मरीज़ गलत सेवा पाते हैं → Genome India संदर्भ पैनल → सटीक चिकित्सा/फार्माकोजीनोमिक्स → अपरिवर्तनीय पारिवारिक डेटा → निजता/भेदभाव का जोखिम → भेदभाव-रोधी क़ानून, DPDP वर्गीकरण और सामुदायिक सहमति। 10-अंक में वादा बनाम अधूरी नैतिकता तालिका, तीन पंक्तियाँ प्रत्येक।
नैतिकता और शासन का पक्ष
विज्ञान पूछता है “क्या हम कर सकते हैं?” नैतिकता पूछती है “करना चाहिए, किसकी शर्तों पर?” जनजातीय भागीदार का जीनोम समुदाय को घेरता है; मरीज़ को न बदली जा सकने वाली झुकाव पर बीमा रुक सकता है। हमदर्दी को डिज़ाइन में बदलें: संवेदनशील वर्गीकरण, सामुदायिक सहमति/लाभ-बाँट, आनुवंशिकी-स्तर सुरक्षा और भेदभाव-रोधी क़ानून। लक्ष्य जायज़ है, वैधता सहमति, सुरक्षा और समानता पर है।
आँकड़ों को यांत्रिक बनाए बिना कैसे लिखें?
तीन संख्याएँ: पैमाना 10,074 जीनोम; फ़ायदा 4.4 करोड़-से-ज़्यादा नए रूपांतर; अंतर दक्षिण एशियाई 1% से कम। आँकड़े के बाद मतलब लिखें। लेबल सटीक रखें: 13 करोड़ कुल, उनमें 2.7 करोड़ दुर्लभ। बड़ी पंक्ति जो तथ्य, कारण या सुधार नहीं देती, काटें।
सामान्य प्रश्न
Genome India Project क्या है और चरण 1 ने क्या हासिल किया?
DBT पहल जनवरी 2020 में शुरू हुई और करीब 20 संस्थानों ने IISc Centre for Brain Research और CSIR-CCMB के तालमेल में चलाई। चरण 1 ने करीब 83 समूहों से 10,074 पूर्ण जीनोम का अनुक्रम निकाला और गुमनाम डेटासेट 9 जनवरी 2025 को सार्वजनिक किया, भारतीय आबादी ढाँचे का पहला पूर्ण-जीनोम संदर्भ बनाया।
वैश्विक डेटाबेस होते हुए भारत को अपना जीनोम डेटा क्यों चाहिए?
वैश्विक नमूने करीब 86% यूरोपीय और दक्षिण एशियाई 1% से कम हैं। जोखिम अंक/दवा खुराक भारतीयों पर चूक सकते हैं। भारतीय अंतर्विवाह संस्थापक उत्परिवर्तन जमा करती है जिन्हें भारत-विशेष संदर्भ पहचानता है, यूरोपीय नहीं।
मुख्य नैतिक और क़ानूनी जोखिम क्या हैं?
जीनोम स्थायी, भविष्य बताने वाला और पारिवारिक है, लेकिन भारत में आनुवंशिक भेदभाव-रोधी क़ानून नहीं और DPDP Act इसे संवेदनशील नहीं मानता। Tayal बीमा फैसला आंशिक रोक में है। जनजातीय/सामुदायिक सहमति और गुमनाम जीनोम की फिर-पहचान खुली चिंताएँ हैं।
Genome India, UK Biobank और USA की All of Us से कैसे अलग है?
कच्चा पैमाना छोटा है। UK Biobank करीब 5,00,000 जीनोम और USA की All of Us 7,25,000 से ज़्यादा नामांकित भागीदार रखता है; Genome India चरण 1 10,074, करीब 50 गुना छोटा। डिज़ाइन का दावा पैमाना नहीं, कम अध्ययन की गई अत्यंत विविध आबादी है; लंबी महत्वाकांक्षा दस लाख जीनोम की है।