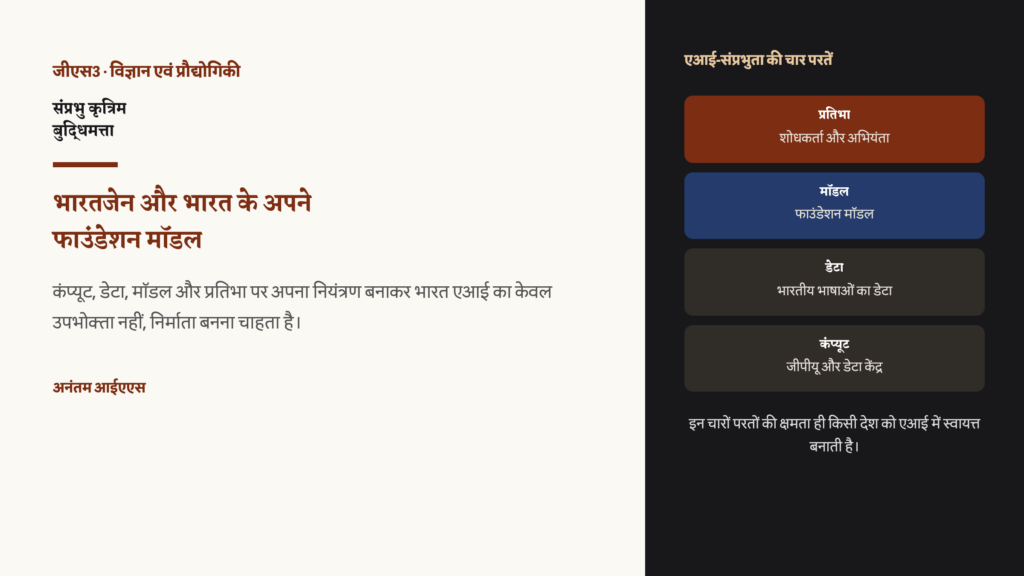
पिछले तीन वर्षों में चैटबॉट को प्रॉम्प्ट देने वाला लगभग हर भारतीय अनजाने में उधार की व्यवस्था पर निर्भर था। जवाब देने वाला मॉडल विदेश में प्रशिक्षित था, मुख्यतः अंग्रेजी वेब-पृष्ठों से जुटाए डेटा पर; उसके ग्राफिक्स चिप एक अमेरिकी कंपनी से आते थे और क्लाउड सर्वर तीन विदेशी कंपनियों के थे। यह व्यवस्था उपयोगी थी, लेकिन बिजली या दूरसंचार जितनी रणनीतिक हो चुकी तकनीक में भारत को दूसरों के ढांचे पर निर्भर भी बनाती थी। इसी चिंता का उत्तर है संप्रभु AI: अपनी कृत्रिम बुद्धिमत्ता को शुरू से अंत तक बनाने और नियंत्रित करने की राष्ट्रीय क्षमता, उसे किराये पर लेने की नहीं।
भारतजेन इस महत्वाकांक्षा का सबसे स्पष्ट रूप है। 2024 के अंत में शुरू हुई यह भारत की पहली सरकारी-वित्तपोषित स्वदेशी, बहुभाषी और मल्टीमॉडल बड़े भाषा मॉडल बनाने की पहल है। इसके ऊपर कहीं बड़ी IndiaAI Mission है, लगभग ₹10,372 करोड़ का कार्यक्रम, जो GPU, डेटासेट, कौशल और धन उपलब्ध कराने के लिए बनाया गया है। UPSC के लिए यह GS3 विज्ञान एवं प्रौद्योगिकी का विषय है, जिसमें GS2 शासन का मजबूत पक्ष भी जुड़ता है। इसे नारे की तरह नहीं, एक व्यवस्था की तरह समझना चाहिए।
संप्रभु AI का वास्तविक अर्थ
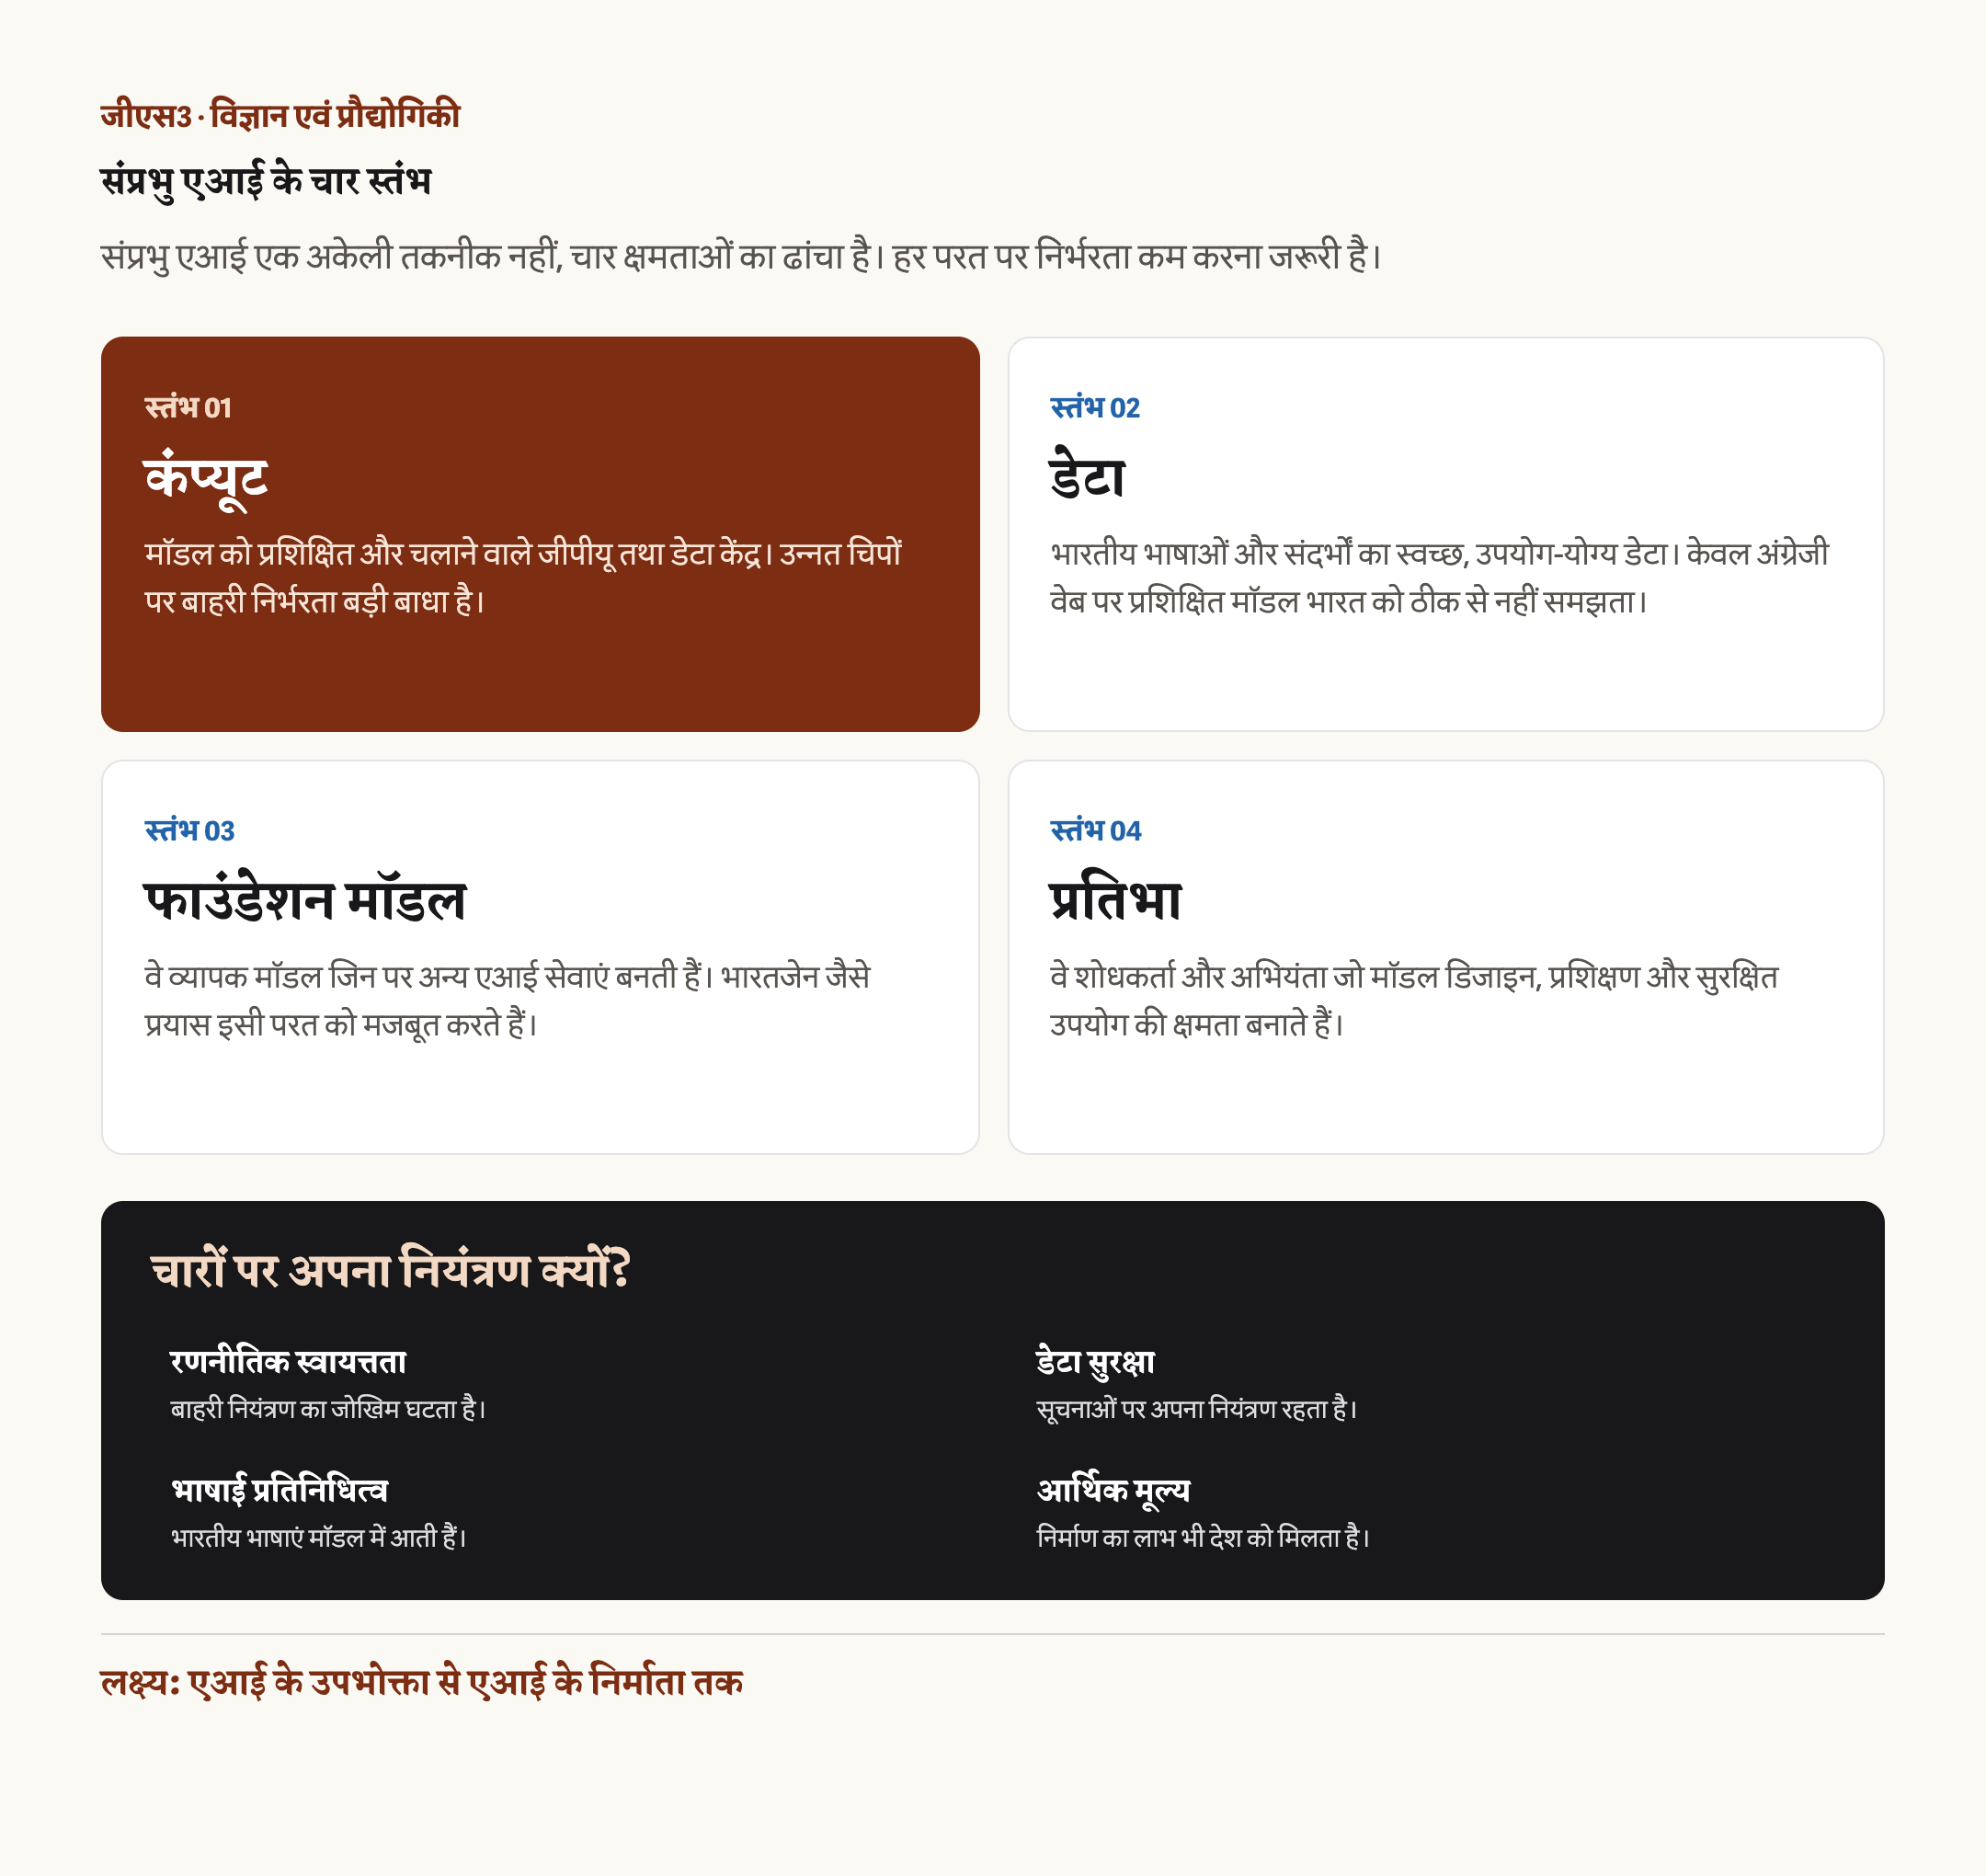
‘संप्रभु AI’ शब्द बहुत ढीले ढंग से इस्तेमाल होता है। मूल अर्थ है किसी देश की अपने AI स्टैक के महत्वपूर्ण हिस्सों को विदेशी प्रदाताओं पर निर्भर हुए बिना बनाने, उसका स्वामित्व रखने और नियंत्रित करने की क्षमता। इस स्टैक के चार स्तंभ हैं, और भारत ऐतिहासिक रूप से चारों में कमजोर रहा है।
पहला है कंप्यूट: मॉडल को प्रशिक्षित और चलाने की प्रसंस्करण क्षमता, जो बड़े डेटा केंद्रों में रखे विशेष GPU से मिलती है। उन्नत मॉडल महीनों तक हजारों चिपों पर प्रशिक्षित होते हैं और उच्चस्तरीय चिपों में Nvidia, अमेरिका का प्रभुत्व है। दूसरा है डेटा; अंग्रेजी वेब-पाठ पर प्रशिक्षित मॉडल कैलिफोर्निया में सहज और छत्तीसगढ़ में असहज हो सकता है। तीसरा है आधार मॉडल (foundation model), अर्थात बड़े सामान्य-उद्देश्य न्यूरल नेटवर्क जिन पर अन्य अनुप्रयोग बनते हैं। चौथा है प्रतिभा: इन्हें डिजाइन, प्रशिक्षित और संरेखित करने वाले शोधकर्ता तथा इंजीनियर, जिन्हें भारत अपने पास रखने से अधिक विदेश भेजता रहा है।
इन चारों का स्वामित्व सार्वजनिक धन के योग्य क्यों है? पहला, रणनीतिक स्वायत्तता: अंतरिक्ष और परमाणु कार्यक्रमों जैसी सोच कि निर्यात-नियंत्रण या किसी विदेशी कंपनी की कीमत-नीति के पीछे महत्वपूर्ण क्षमता नहीं फँसनी चाहिए। दूसरा, डेटा स्थानीयकरण और सुरक्षा: नागरिक अभिलेख, सरकारी दस्तावेज और रक्षा-संबंधी सूचना विदेशी भूमि पर चल रहे मॉडल से संसाधित हों तो यह संप्रभुता का प्रश्न है। तीसरा, भाषाई और सांस्कृतिक प्रतिनिधित्व: वैश्विक मॉडल भारतीय भाषाओं, लिपियों और संदर्भों के लिए बने ही नहीं थे। चौथा, आर्थिक मूल्य: इस दशक में AI से भारत की अर्थव्यवस्था में सैकड़ों अरब डॉलर जुड़ने की संभावना है; केवल उपभोक्ता देश उत्पादक देश से बहुत कम मूल्य पाता है।
भारतजेन: भारत का पहला सरकारी-वित्तपोषित आधार मॉडल
भारतजेन स्वदेशी, मल्टीमॉडल और बहुभाषी बड़े भाषा मॉडल बनाने की भारत की पहली सरकारी पहल है, जिसका अनावरण 30 सितंबर 2024 को हुआ। मल्टीमॉडल होने का अर्थ है कि यह केवल पाठ नहीं, वाणी और चित्र भी संभाल सकता है: जैसे स्कैन किया भू-अभिलेख पढ़ना, मराठी में किसान का प्रश्न सुनना और उसी भाषा में उत्तर देना। बहुभाषिकता इसका अतिरिक्त गुण नहीं, इसका मूल उद्देश्य है।
संस्थागत ढाँचा याद रखना जरूरी है। भारतजेन, विज्ञान एवं प्रौद्योगिकी विभाग (DST) के अंतरविषयक साइबर-भौतिक प्रणालियों पर राष्ट्रीय मिशन (National Mission on Interdisciplinary Cyber-Physical Systems, NM-ICPS) के अंतर्गत है; यह MeitY की IndiaAI Mission से अलग विज्ञान मंत्रालय की परियोजना है। IIT Bombay इसका नेतृत्व करता है और TIH Foundation for IoT and IoE के साथ IIT Madras, IIT Kanpur, IIT Hyderabad, IIT Mandi, IIIT Hyderabad तथा IIM Indore जैसे साझेदार जुड़े हैं। DST के अनुसार इसका लक्ष्य भाषा, वाणी और कंप्यूटर विजन में आधारभूत मॉडल बनाकर सार्वजनिक सेवाओं और नागरिक भागीदारी को बेहतर करना था; पहला चरण लगभग दो वर्ष का था।
यह केवल घोषणा नहीं रहा। भारतजेन ने ‘Param’ नाम से मॉडल जारी किए हैं। Param-1 2.9 अरब पैरामीटर का आधारभूत पाठ मॉडल है, जिसे लगभग 7.5 ट्रिलियन टोकन पर प्रशिक्षित किया गया और करीब एक-तिहाई डेटा भारतीय सामग्री था; इसका आधार हिंदी और अंग्रेजी है। Patram, लगभग 7 अरब पैरामीटर का भारत का पहला दस्तावेज़-दृष्टि (document-vision) मॉडल, भारतीय भाषाओं और अंग्रेजी में जटिल दस्तावेजी लेआउट पढ़ सकता है। लक्ष्य 22 अनुसूचित भाषाओं तक पहुँच और ओपन-सोर्स रिलीज का है। पैरामीटर मॉडल के समायोज्य भार हैं; अधिक पैरामीटर सामान्यतः अधिक क्षमता, लेकिन कहीं अधिक कंप्यूट मांगते हैं।
IndiaAI Mission: मॉडलों के आसपास का ढाँचा
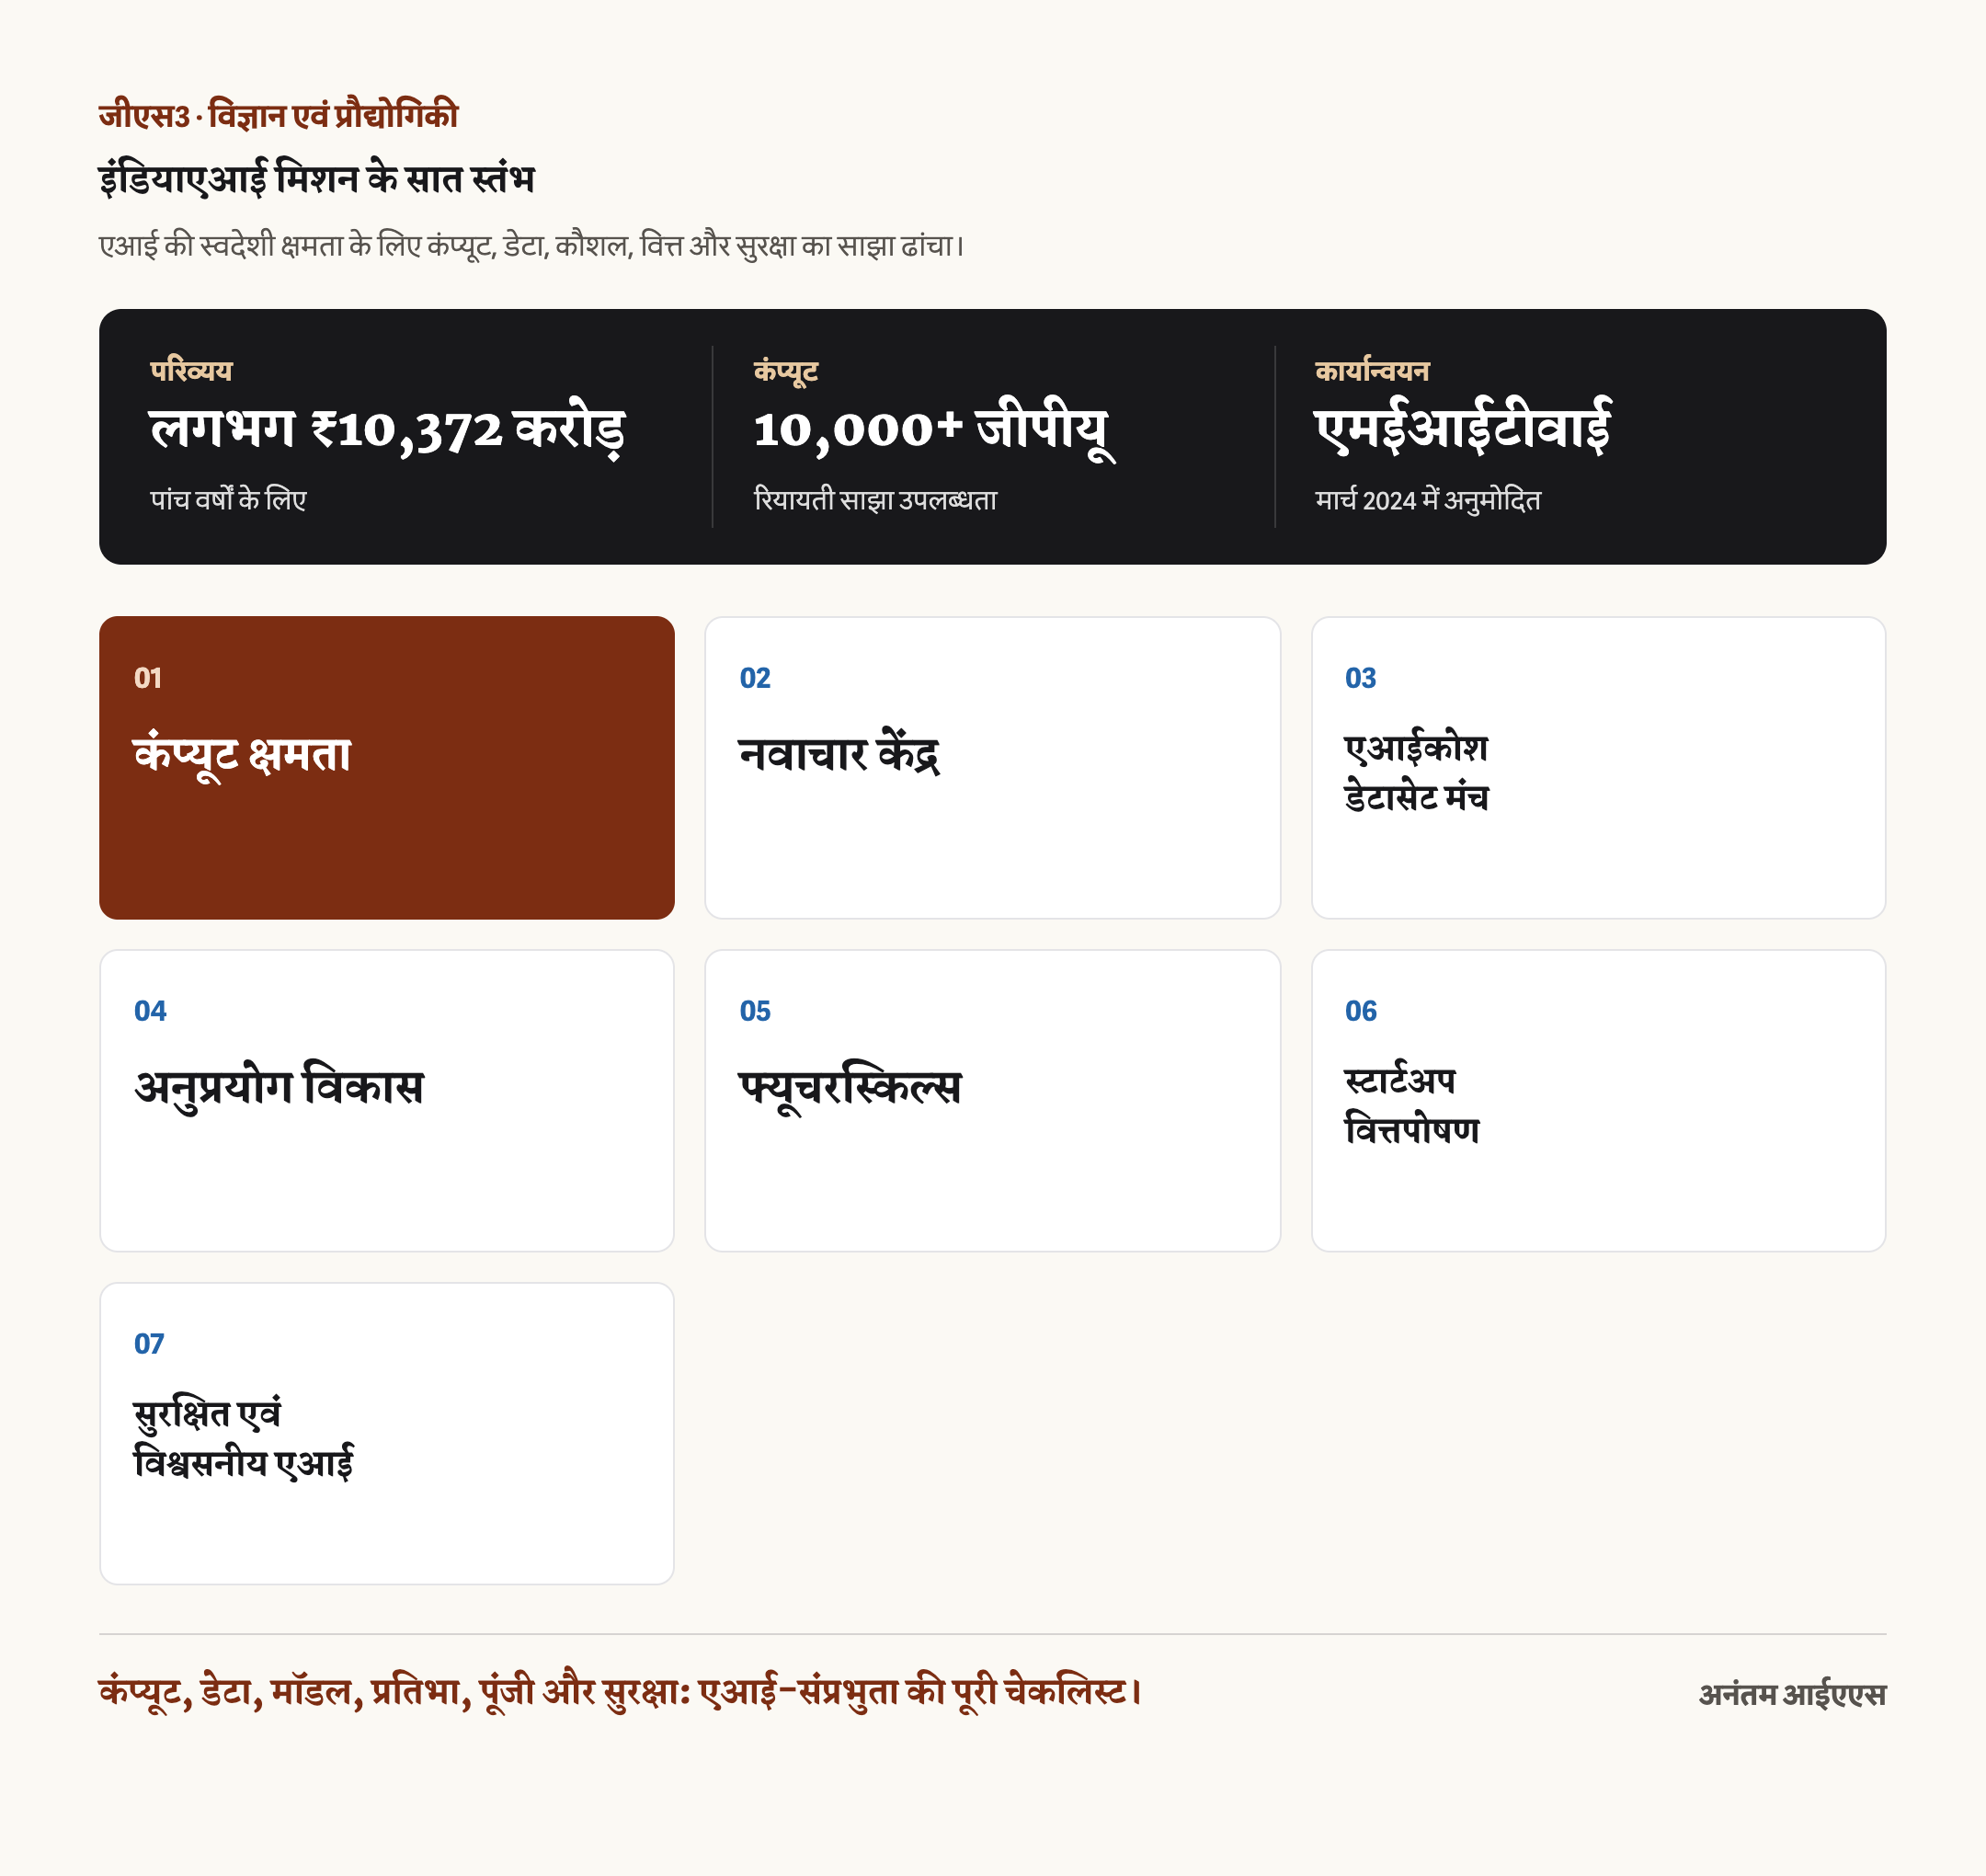
इस मिशन के बिना भारतजेन एक अकेला प्रयास होता। मार्च 2024 में केंद्रीय मंत्रिमंडल ने MeitY के अंतर्गत पांच वर्षों के लिए लगभग ₹10,371.92 करोड़ के व्यय के साथ इसे मंजूरी दी। इसका उद्देश्य एक-एक मॉडल को निधि देना नहीं, बल्कि स्वदेशी AI उद्योग के लिए पूरा परिवेश बनाना है। इसका सूत्र-वाक्य, “Making AI in India and Making AI Work for India”, क्षमता बनाने और उसे भारतीय समस्याओं पर लगाने, दोनों बातों को समेटता है।
मिशन के सात स्तंभ हैं। IndiaAI Compute Capacity का उद्देश्य सार्वजनिक-निजी भागीदारी (PPP) के माध्यम से 10,000 से अधिक GPU जुटाकर स्टार्टअप और शोधकर्ताओं को रियायती दर पर देना है। IndiaAI Innovation Centre स्वदेशी बड़े मल्टीमॉडल और क्षेत्र-विशेष मॉडल विकसित करता है। IndiaAI Datasets Platform, AIKosh, नैतिक उपयोग के लिए उच्च गुणवत्ता वाले गैर-व्यक्तिगत डेटासेट जुटाता और साफ करता है। शेष स्तंभ हैं Application Development, FutureSkills, Startup Financing और Safe & Trusted AI। यानी कंप्यूट, डेटा, मॉडल, कौशल, धन और सुरक्षा-नियम, सभी एक ही ढाँचे में हैं।
मूल लक्ष्य से आगे बढ़ते हुए सरकार ने लगभग 38,000 GPU तक का पूल बनने की बात कही है। इन्हें ₹65 प्रति GPU-घंटा जैसी रियायती दर पर उपलब्ध कराने का उल्लेख हुआ है। इसकी अलग पहचान साझा कंप्यूट मॉडल है: हर स्टार्टअप अपना क्लस्टर बनाने के बजाय राज्य के एकत्रित ढाँचे को सस्ते में किराये पर ले सके। प्रश्न यह है कि मांग, डेटा और प्रतिभा सिलिकॉन की इस वृद्धि के साथ चल पाएंगे या नहीं।
स्वदेशी मॉडल बनाने की पहल और निर्माता
मिशन ने ढाँचे के साथ वास्तविक संप्रभु आधार मॉडल बनवाने के प्रस्ताव भी आमंत्रित किए। 2025 में चुनी गई टीमों को रियायती कंप्यूट मिला। अप्रैल 2025 में Sarvam AI को संप्रभु LLM के लिए चुना गया; उसके प्रस्ताव में लगभग 120 अरब पैरामीटर के बड़े मॉडल और पर्याप्त भारतीय-भाषा डेटा का लक्ष्य बताया गया। Sarvam-M 24 अरब पैरामीटर का भारतीय भाषाओं और तर्क के लिए तैयार मॉडल है। Soket AI, Gnani AI और Gan AI जैसे नाम भी चुनी गई टीमों में आए हैं।
तस्वीर को बढ़ा-चढ़ाकर नहीं देखना चाहिए। Krutrim जैसे निजी प्रयास भी हैं; भव्य अग्रवाल के उद्यम ने जनवरी 2024 में भारत का पहला AI यूनिकॉर्न (unicorn) बनने का दावा किया और Krutrim-2 जैसा 12 अरब पैरामीटर बहुभाषी मॉडल ओपन-सोर्स किया। फिर भी 2025 के अंत तक उसके क्लाउड सेवाओं की ओर मुड़ने की खबरें आईं, जो बताती हैं कि अग्रणी (frontier) मॉडल प्रशिक्षण अत्यंत महँगा है। सही निष्कर्ष यह नहीं कि भारत ने ChatGPT का प्रतिद्वंद्वी बना लिया है, बल्कि यह कि भारत के पास भारतजेन, Sarvam और Krutrim जैसे छोटे-मध्यम, भाषा-केंद्रित मॉडलों का पोर्टफोलियो है।
महत्त्व और संभावित विफलताएँ
सबसे मजबूत तर्क भाषाई समावेशन है। भारत की 22 अनुसूचित भाषाओं और सैकड़ों मातृभाषाओं में केवल अंग्रेजी जानने वाला मॉडल पर्याप्त नहीं है। स्वदेशी मॉडल को भाषिणी से जोड़ा जाए तो ओड़िया में पेंशन प्रश्न, तेलुगु में फसल सलाह या तमिल में अदालत आदेश सुनाने जैसी सार्वजनिक सेवाएँ संभव बनती हैं। यही जनहित AI, रणनीतिक स्वायत्तता और कर-धन के उपयोग का आधार है।
चुनौतियाँ भी उतनी ही वास्तविक हैं। भारत GPU खरीदता है, बनाता नहीं; इसलिए संप्रभु AI अभी आयातित सिलिकॉन पर चलता है। अग्रणी प्रशिक्षण में करोड़ों डॉलर लगते हैं। स्वच्छ, अधिकार-स्पष्ट भारतीय-भाषा डेटा कम है, प्रतिभा विदेश जाती है और डेटा केंद्र भारी बिजली खाते हैं। DPDP Act, 2023 और 2025 में अधिसूचित विस्तृत नियम निजी डेटा के उपयोग को नियंत्रित करते हैं। नवंबर 2025 में MeitY ने ‘सात सूत्र’ (Seven Sutras) पर आधारित India AI Governance Guidelines जारी कीं, जिनमें EU-जैसे सर्वसमावेशी AI अधिनियम के बजाय हल्के, नवाचार-समर्थक ढाँचे को चुना गया। भारत के पास अब धन, कंप्यूट और राजनीतिक इच्छा है, पर अगले तीन वर्ष तय करेंगे कि यह महत्वाकांक्षा उपलब्धि बनती है या नहीं।
मुख्य परीक्षा उत्तर के लिए
यह GS पत्र 3 में विज्ञान-प्रौद्योगिकी और प्रौद्योगिकी के स्वदेशीकरण के अंतर्गत उपयुक्त है; डिजिटल सार्वजनिक अवसंरचना, ई-गवर्नेंस या उभरती तकनीक के नियमन में GS पत्र 2 का पक्ष भी जुड़ता है। निबंध में आत्मनिर्भरता, विकास और तकनीक से इसे जोड़ा जा सकता है। परीक्षक केवल ‘भारतजेन’ की वर्तनी नहीं, देश के अपने AI बनाने के कारण और उसकी कीमतें समझने की क्षमता देखता है।
उत्तर की संरचना
संप्रभु AI को कंप्यूट, डेटा, मॉडल और प्रतिभा की चार-स्तंभीय क्षमता के रूप में परिभाषित करें। फिर भारतजेन को DST/NM-ICPS और IIT Bombay से, तथा IndiaAI Mission को MeitY से जोड़ें। भाषिणी, रणनीतिक स्वायत्तता और सेवा-प्रदाय का महत्त्व लिखें; चिप निर्भरता, लागत, डेटा, प्रतिभा, ऊर्जा और नियमन की आलोचना जोड़ें। परिभाषा, स्थिति, महत्त्व, आलोचना और निष्कर्ष का क्रम लगभग हर स्वदेशी-तकनीक प्रश्न में चलेगा।
सामान्य गलतियों से बचें
भारतजेन को DST और IndiaAI Mission को MeitY से अलग रखें। भारत ने ChatGPT का समकक्ष बना लिया है, ऐसा दावा न करें। एक-दो पैरामीटर आंकड़े पर्याप्त हैं। चिप और ऊर्जा निर्भरता को छोड़ना उत्तर को एकतरफा बना देगा।
संक्षिप्त उत्तर-ढाँचा
संप्रभु AI = कंप्यूट + डेटा + मॉडल + प्रतिभा → स्वायत्तता, स्थानीयकरण, भाषा और अर्थव्यवस्था → भारतजेन (DST/NM-ICPS, IIT Bombay, Param) → IndiaAI Mission (लगभग ₹10,372 करोड़, सात स्तंभ, GPU) → Sarvam सहित मॉडल → भाषिणी व शासन → चिप, लागत, डेटा, प्रतिभा, ऊर्जा, DPDP Act और 2025 दिशानिर्देश → संतुलित निष्कर्ष।
आरेख या फ्लोचार्ट
चार-परत पिरामिड बनाइए: आधार में कंप्यूट (GPU, डेटा केंद्र), फिर डेटा (AIKosh, भाषिणी), फिर मॉडल (भारतजेन, Sarvam) और शीर्ष पर प्रतिभा। शीर्षक दें: “AI-संप्रभु बनने के लिए देश को क्या नियंत्रित करना चाहिए।”
संतुलित निष्कर्ष
“भारत के पास पहली बार संप्रभु AI का प्रयास करने के लिए पूंजी, कंप्यूट और राजनीतिक इच्छा है; आयातित चिपों, पलायन करती प्रतिभा और अतिनियमन के बिना इस आधार को भरोसेमंद उन्नत मॉडलों में बदलना अगले तीन वर्षों की कसौटी है।”
डेटा का उपयोग
बस कुछ आधार-आंकड़े याद रखें: IndiaAI Mission का लगभग ₹10,372 करोड़ का पांच-वर्षीय व्यय, 10,000+ GPU लक्ष्य जिसका विस्तार लगभग 38,000 की ओर हुआ, भारतजेन की 30 सितंबर 2024 शुरुआत और DPDP Act 2023 के साथ 2025 AI दिशानिर्देश। इन्हें संदर्भ सहित लिखें, सूची की तरह नहीं।
सामान्य प्रश्न
सरल शब्दों में संप्रभु AI क्या है? यह किसी देश की GPU व डेटा केंद्र जैसे कंप्यूट, डेटा, आधार मॉडल और प्रतिभा को स्वयं बनाने, उसका स्वामित्व और नियंत्रण रखने की क्षमता है। यह रणनीतिक स्वायत्तता, डेटा सुरक्षा, स्थानीय भाषाओं के प्रतिनिधित्व और देश में AI का आर्थिक मूल्य रखने के लिए महत्वपूर्ण है।
भारतजेन क्या है और इसे कौन चलाता है? भारतजेन 30 सितंबर 2024 को शुरू हुई स्वदेशी, मल्टीमॉडल और बहुभाषी LLM पहल है। यह DST के NM-ICPS के अंतर्गत IIT Bombay और TIH Foundation द्वारा संचालित है; IIT Madras, IIT Kanpur और IIIT Hyderabad सहित संस्थान इसके साझेदार हैं। Param परिवार के मॉडल भारतीय भाषाओं के लिए जारी किए गए हैं।
भारतजेन और IndiaAI Mission में अंतर क्या है? भारतजेन DST के अंतर्गत एक विशिष्ट मॉडल-निर्माण परियोजना है। IndiaAI Mission MeitY का लगभग ₹10,372 करोड़ का व्यापक कार्यक्रम है, जो रियायती GPU, AIKosh डेटासेट, कौशल, स्टार्टअप धन और नवाचार केंद्र उपलब्ध कराता है तथा Sarvam AI जैसी टीमों को भी मॉडल बनाने के लिए चुनता है।
भारत की संप्रभु AI महत्वाकांक्षा की बड़ी चुनौतियाँ क्या हैं? भारत GPU खरीदता है, बनाता नहीं। इसके साथ अग्रणी मॉडल प्रशिक्षण की भारी लागत, स्वच्छ भारतीय-भाषा डेटा की कमी, प्रतिभा पलायन, डेटा केंद्रों की ऊर्जा मांग और DPDP Act 2023 तथा 2025 AI दिशानिर्देश के तहत उद्योग को रोके बिना नियमन की चुनौती है।
अभ्यास प्रश्न
प्रीलिम्स MCQ
- भारतजेन के संदर्भ में निम्नलिखित कथनों पर विचार कीजिए:
(a) इसका नेतृत्व IIT Bombay करता है
(b) यह DST के National Mission on Interdisciplinary Cyber-Physical Systems के अंतर्गत है
(c) यह मल्टीमॉडल, बहुभाषी LLM के रूप में बनाया गया है
(d) इसे 2022 में शुरू किया गया था।
कौन-से कथन सही हैं?
उत्तर: (a), (b) और (c) — भारतजेन IIT Bombay-नेतृत्व वाली DST/NM-ICPS परियोजना है, जिसे 30 सितंबर 2024 को शुरू किया गया। - मार्च 2024 में मंजूर IndiaAI Mission मुख्यतः किस मंत्रालय द्वारा लागू है और इसका लगभग व्यय कितना है?
(a) विज्ञान एवं प्रौद्योगिकी मंत्रालय; ₹5,000 करोड़
(b) इलेक्ट्रॉनिक्स एवं सूचना प्रौद्योगिकी मंत्रालय; लगभग ₹10,372 करोड़
(c) वित्त मंत्रालय; ₹20,000 करोड़
(d) नीति आयोग; ₹1,000 करोड़।
उत्तर: (b) — MeitY इसे लगभग ₹10,371.92 करोड़ के पांच-वर्षीय व्यय से चलाता है। - निम्नलिखित में से कौन IndiaAI Mission के सात स्तंभों में नहीं है?
(a) Compute Capacity
(b) Datasets Platform (AIKosh)
(c) Innovation Centre
(d) Sovereign Wealth Fund।
उत्तर: (d) — सात स्तंभों में ऐसा कोई संप्रभु संपदा कोष नहीं है। - ‘भाषिणी’ का सर्वश्रेष्ठ वर्णन क्या है?
(a) घरेलू GPU निर्माण कार्यक्रम
(b) राष्ट्रीय भाषा-अनुवाद और डिजिटल समावेशन मंच
(c) डेटा स्थानीयकरण कानून
(d) सेमीकंडक्टर फैब।
उत्तर: (b) — भाषिणी भारतीय भाषाओं में अनुवाद और डिजिटल समावेशन का राष्ट्रीय मंच है। - भारत के AI शासन के संदर्भ में विचार कीजिए:
(a) DPDP Act 2023 में बना
(b) इसके विस्तृत नियम 2025 में अधिसूचित हुए
(c) MeitY ने 2025 में सात सूत्र आधारित दिशानिर्देश जारी किए
(d) भारत ने 2025 में EU-जैसा सर्वसमावेशी AI अधिनियम बनाया। कौन सही है?
उत्तर: (a), (b) और (c) — भारत ने EU-जैसे सर्वसमावेशी अधिनियम के बजाय हल्का, सिद्धांत-आधारित दृष्टिकोण चुना।
मुख्य परीक्षा प्रश्न
- “संप्रभु AI 2020 के दशक के लिए वही है जो पहले भारत के लिए अंतरिक्ष और परमाणु कार्यक्रम थे।” स्वदेशी आधार मॉडल बनाने के तर्क की आलोचनात्मक जाँच कीजिए और कंप्यूट, डेटा, मॉडल तथा प्रतिभा में भारत की तैयारी का आकलन कीजिए। (15 अंक, 250 शब्द)
- भारतजेन, IndiaAI Mission और भाषिणी जैसे मंचों की भूमिकाओं में अंतर करते हुए भारत की AI पहल के संस्थागत ढाँचे पर चर्चा कीजिए। ये मिलकर AI में आत्मनिर्भरता को कैसे आगे बढ़ाते हैं? (15 अंक, 250 शब्द)
- स्वदेशी बड़े भाषा मॉडल को भाषाई समावेशन और शासन-सेवा के आधार पर उचित ठहराया जाता है। भारत की 22 अनुसूचित भाषाओं और सार्वजनिक सेवा-प्रदाय के संदर्भ में मूल्यांकन कीजिए। (10 अंक, 150 शब्द)
- “भारत की संप्रभु AI महत्वाकांक्षा अभी भी आयातित सिलिकॉन पर चलती है।” कंप्यूट और चिप निर्भरता की चुनौती तथा अगले दशक में उसे घटाने की यथार्थवादी रणनीति पर चर्चा कीजिए। (15 अंक, 250 शब्द)
- भारत के हल्के, सिद्धांत-आधारित AI शासन दृष्टिकोण, DPDP Act 2023 और 2025 AI दिशानिर्देश की अधिक निर्देशात्मक वैश्विक मॉडलों से तुलना कीजिए। नवाचार और नागरिक-सुरक्षा के बीच क्या कीमतें हैं? (10 अंक, 150 शब्द)