भारत ने 96 साल तक अपनी कल्याण नीति का बड़ा हिस्सा एक अनुमान पर चलाया। देश के सबसे बड़े लाभार्थी समूह अन्य पिछड़ा वर्ग (OBC) के आरक्षण की बुनियाद 1980 से उस संख्या पर है जिसे Mandal Commission ने 1931 की जनगणना से निकालकर 1980 की आबादी पर लगाया था। अनुमान था कि OBC भारत की करीब 52% आबादी हैं। उसके बाद राष्ट्रीय स्तर पर किसी ने गिना नहीं। इसलिए 12 दिसंबर 2025 को केंद्रीय मंत्रिमंडल ने ₹11,718.24 करोड़ के बजट के साथ जनगणना 2027 में जाति गणना मंजूर की, तो यह केवल फ़ॉर्म में एक खाना जोड़ना नहीं था। वादा था कि भारतीय सामाजिक नीति की सबसे पुरानी धारणा की जगह तथ्य आएगा।
इसीलिए लड़ाई इतनी तेज है। जाति गणना आरक्षण और कल्याण को अनुमान के बजाय सबूत दे सकती है। वह जाति को सार्वजनिक श्रेणी के रूप में और पक्का भी कर सकती है, वर्गीकरण में गड़बड़ी पैदा कर सकती है और सर्वोच्च न्यायालय की 1992 की 50% सीमा पर दबाव बढ़ा सकती है। परीक्षा का सवाल यह नहीं कि जाति गिनना अच्छा है या बुरा। सवाल है कि क्या राज्य डेटा इकट्ठा करके न्याय दे सकता है, बिना गिनती को ही जाति गहरी करने वाली चीज बनाए?
मुद्दा क्या है?
असली बहस जनगणना पर नहीं, बल्कि इस पर है कि गिनती गिनी जाने वाली पहचान के साथ क्या करती है। जाति मापने से अन्याय डेटा के सहारे घट सकता है। या जाति राज्य की मशीनरी में एक और सदी के लिए पक्की हो सकती है। दोनों बातें एक साथ सही हो सकती हैं।
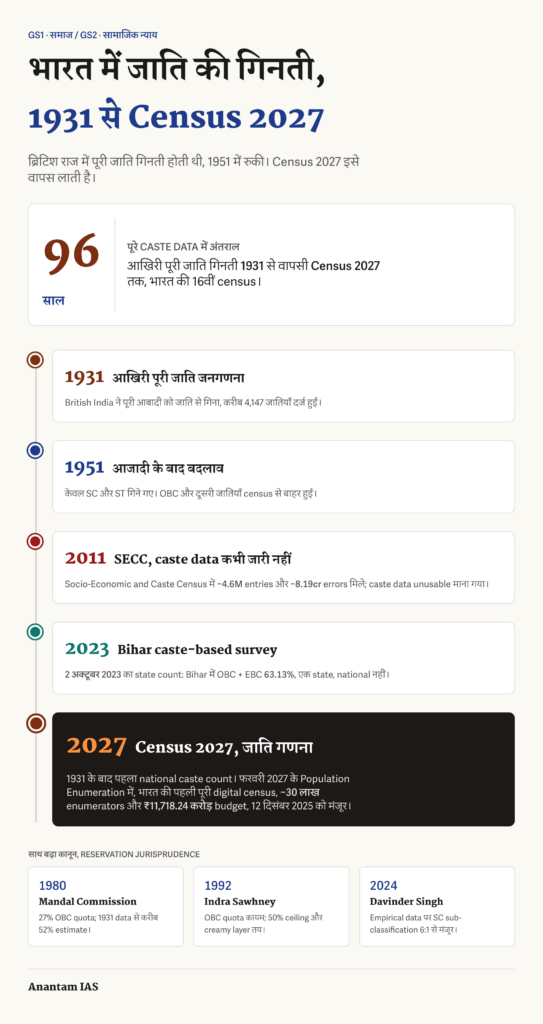
जाति जनगणना (caste census) पूरी आबादी में हर व्यक्ति की जाति की गिनती है। ब्रिटिश राज में यह नियमित थी और आखिरी बार 1931 में हुई। स्वतंत्र भारत की 1951 की पहली जनगणना से राज्य ने केवल अनुसूचित जाति (SC) और अनुसूचित जनजाति (ST), यानी अनुच्छेद 341 और 342 में सूचीबद्ध समूह, गिने। बाकी जातियों की गिनती बंद हो गई। इसलिए जनगणना 2027 नई प्रथा नहीं बनाती, 96 साल पहले छोड़ी गई प्रथा फिर शुरू करती है।
इन दशकों के डेटा में गायब समूह अन्य पिछड़ा वर्ग (OBC) है। यह SC या ST से अलग सामाजिक और शैक्षणिक रूप से पिछड़ी जातियों की व्यापक श्रेणी है। 1979 में बना और 1980 में रिपोर्ट देने वाला Mandal Commission केंद्र सरकार की नौकरियों और शिक्षा में OBC को 27% आरक्षण देने की सिफारिश लेकर आया। उसके पास नई गिनती नहीं थी। उसने 1931 की जाति संख्या से SC, ST और अगड़ी जाति का हिस्सा घटाकर करीब 52% OBC अनुमान निकाला। यही निकाली गई संख्या तब से OBC नीति का आधार है।
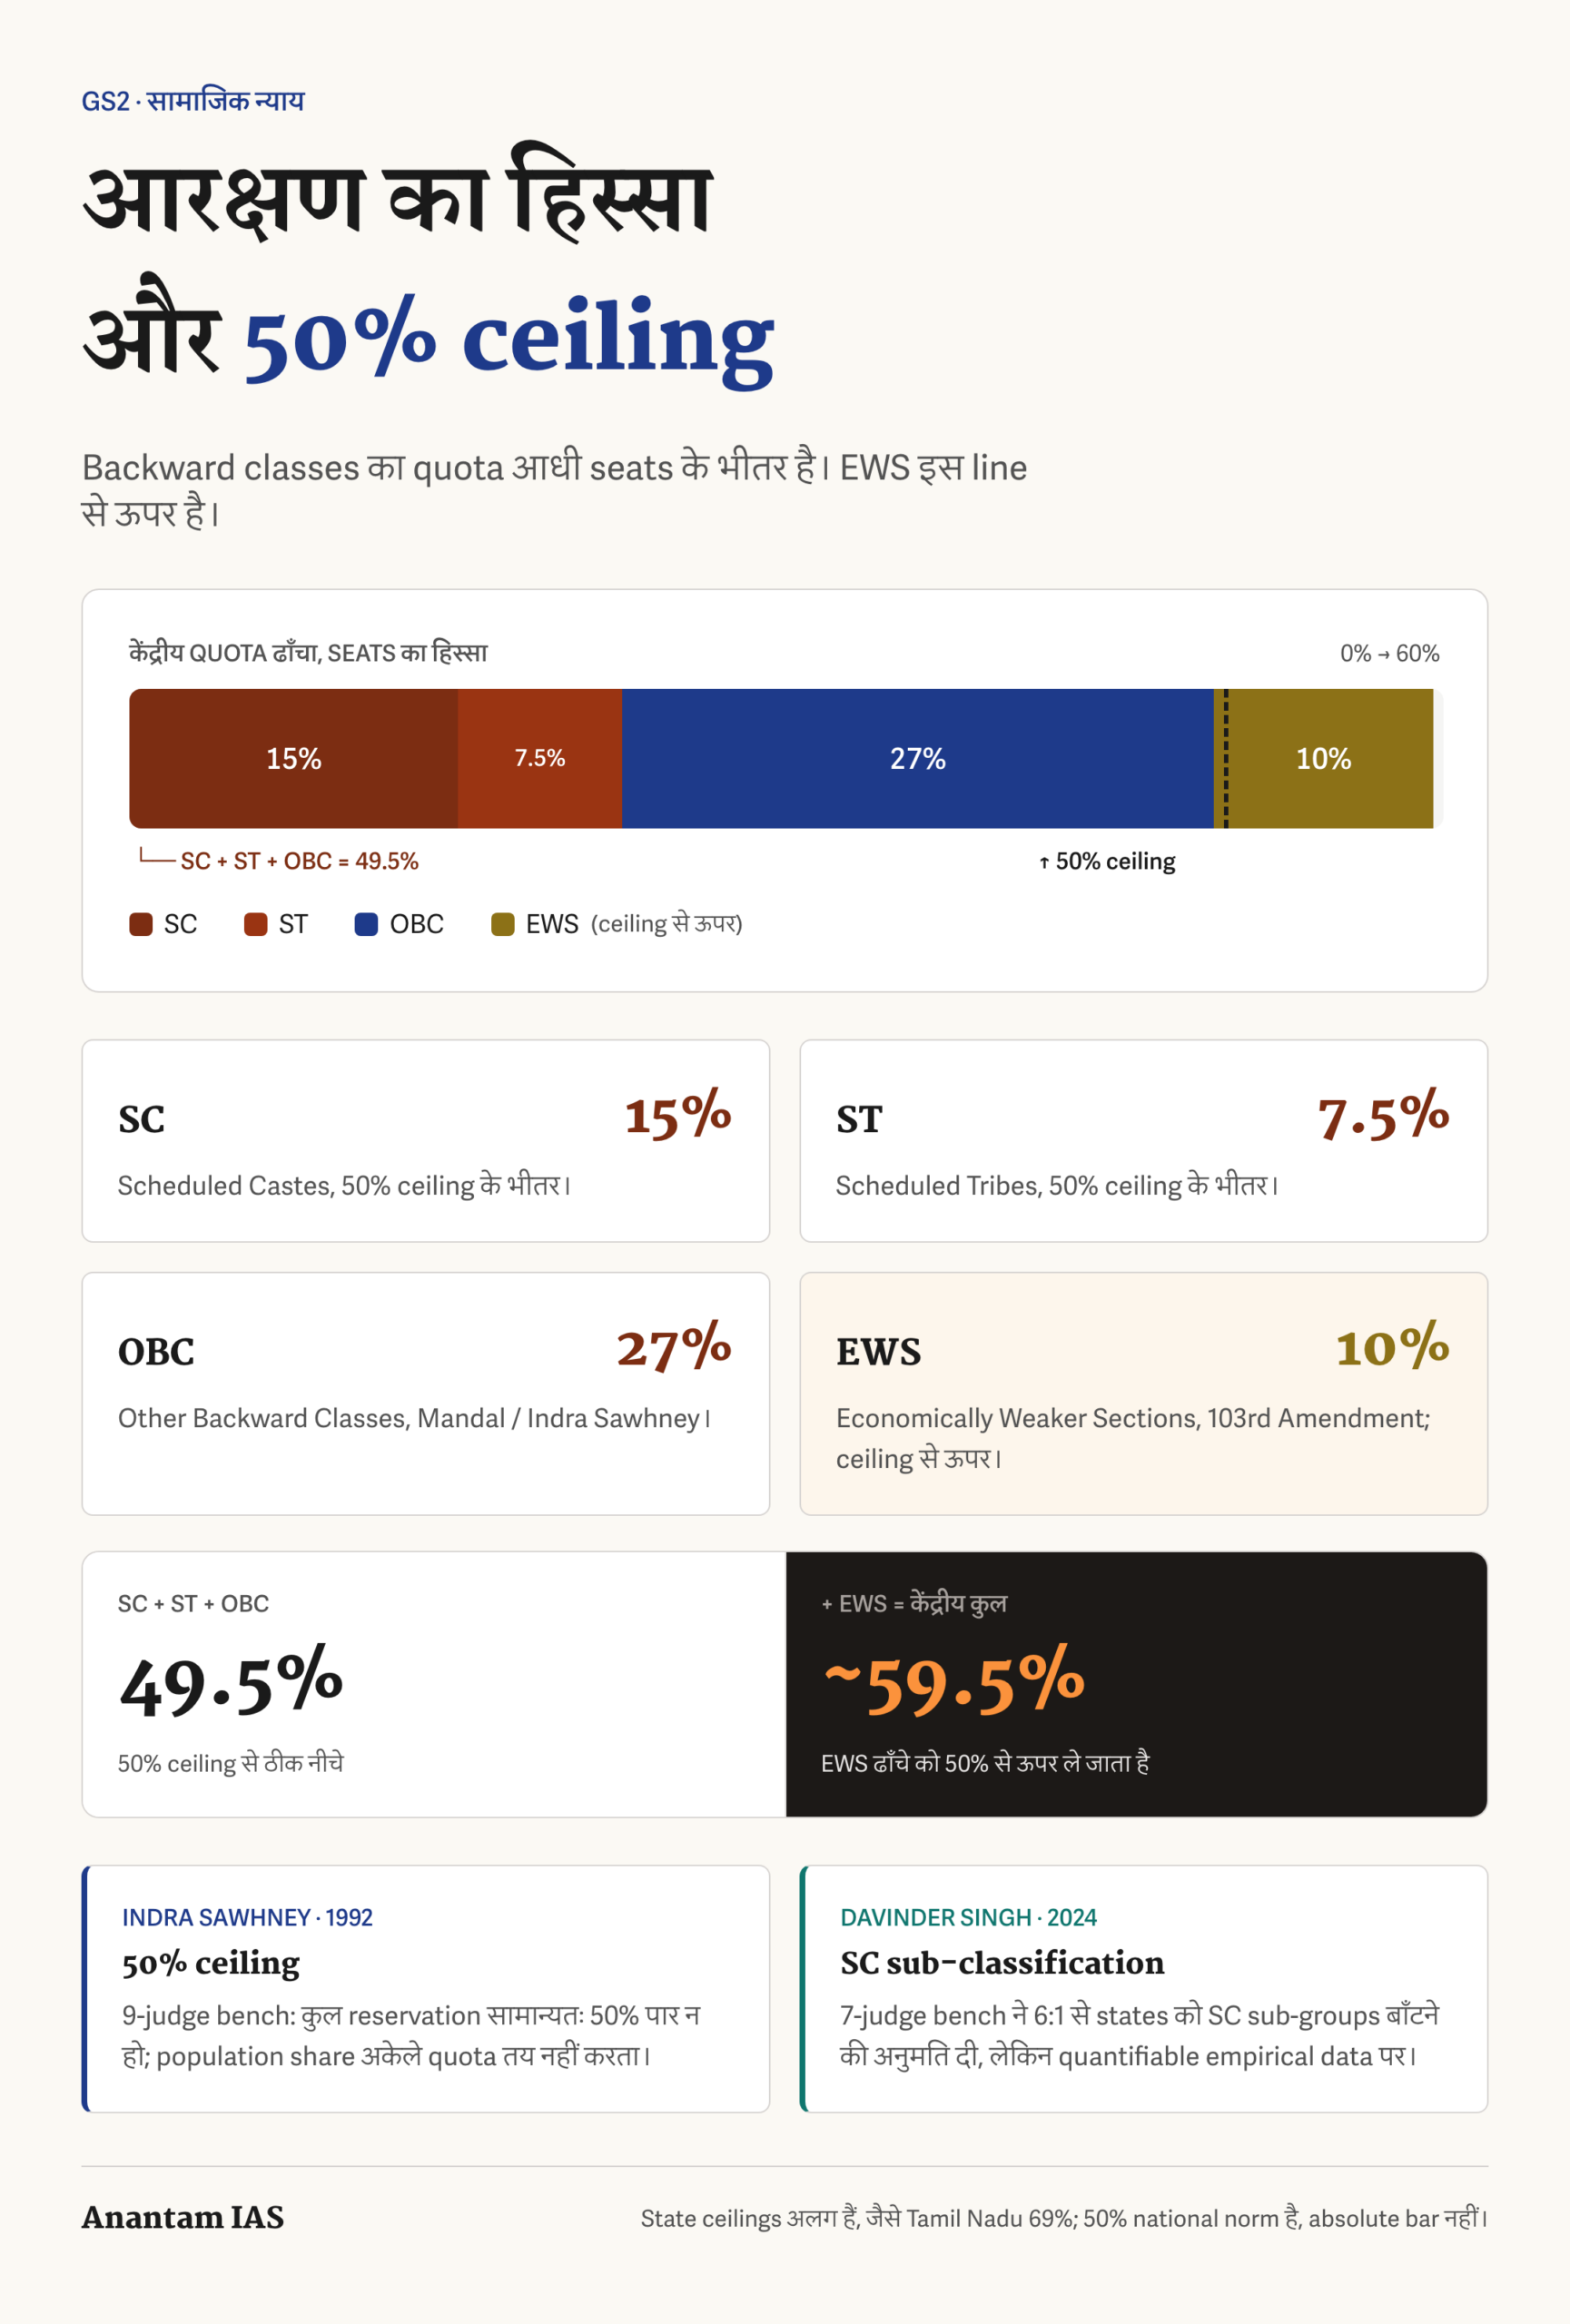
चार और शब्द याद रखें। आरक्षण SC, ST, OBC और अब आर्थिक रूप से कमज़ोर वर्ग (EWS) के लिए सीटों व पदों का कोटा है। क्रीमी लेयर (creamy layer) OBC के भीतर बेहतर स्थिति वाला हिस्सा है, जिसे कोटा से बाहर रखा जाता है ताकि लाभ सच में पिछड़े लोगों तक पहुँचे। 50% सीमा सर्वोच्च न्यायालय का 1992 का नियम है कि कुल आरक्षण सामान्यतः आधी सीटों से ऊपर न जाए। उप-वर्गीकरण आरक्षित श्रेणी को छोटे समूहों में बाँटना है, ताकि सबसे वंचित उपसमूह को अलग हिस्सा मिल सके।
भारत लगभग एक सदी बाद ऐसे क़ानूनी तंत्र में जाति गिनने जा रहा है जो अनुमान पर बना और जिसमें अदालतें अब वही डेटा माँग रही हैं जो जनगणना दे सकती है। वादा और खतरा एक ही कसरत में हैं।
आँकड़े क्या बताते हैं?
गिनती का पक्ष इस बात से शुरू होता है कि भारत अब तक कितना अनुमान लगा रहा है। Mandal Commission का करीब 52% OBC अनुमान 1931 पर आधारित था। राष्ट्रीय नमूना सर्वेक्षण कार्यालय (NSSO) ने OBC हिस्सा 1999-2000 में करीब 36% और 2007 में करीब 41% बताया। एक ही आबादी के तीन अच्छे अनुमान 36% से 52% के बीच हों तो वह डेटा नहीं, डेटा की शक्ल में झगड़ा है। 16 प्रतिशत अंक का यही अंतर नई गिनती का सीधा आधार है।
भारत ने 2011 में कोशिश की थी और वह चेतावनी है। सामाजिक-आर्थिक और जाति जनगणना (SECC) 2011 ने आय व संपत्ति के साथ जाति जुटाई। सामाजिक-आर्थिक हिस्सा 2015-16 में जारी हुआ, जाति हिस्सा कभी नहीं। खुले अंत वाली प्रविष्टियों से जाति, उपजाति, उपनाम, गोत्र और कबीले के करीब 4.6 मिलियन अलग प्रविष्टियाँ निकलीं, जिन्हें वर्गीकृत करना मुश्किल था। जाति विवरण में करीब 8.19 करोड़ गलतियाँ मिलीं। लगभग 6.74 करोड़ ठीक हुईं और करीब 1.46 करोड़ अनसुलझी रहीं। NITI Aayog में Arvind Panagariya की अध्यक्षता वाला विशेषज्ञ समूह जाँच के लिए बना, लेकिन निष्कर्ष दबे रहे। 2021 में सर्वोच्च न्यायालय ने जारी करने का आदेश देने से इनकार किया, क्योंकि केंद्र ने डेटा को इस्तेमाल के लायक नहीं बताया। मिसाल यह नहीं कि जाति गिनी और काम हुआ। मिसाल यह है कि गिनती ढह गई।
हाल का उलटा उदाहरण बिहार है। 2 अक्टूबर 2023 को जारी जाति-आधारित सर्वेक्षण में OBC और अत्यंत पिछड़ा वर्ग (EBC) साथ में 63.13% थे: EBC 36.01%, OBC 27.12%, SC 19.65%, ST 1.68% और सामान्य या अनारक्षित 15.52%। सबसे बड़ा अकेला समूह यादव करीब 14.27% था। बिहार ने साबित किया कि सर्वेक्षण करके डेटा जारी हो सकता है। लेकिन यह 13 करोड़ लोगों का एक राज्य है। उसके 63% पिछड़े हिस्से को पूरे भारत पर लगाना वही गलती होगी जो Mandal के 1931 डेटा के विस्तार में हुई।
जनगणना 2027 कागज़ पर SECC की गड़बड़ी से बचने के लिए बनी है। यह भारत की पहली पूरी डिजिटल जनगणना होगी। आबादी गणना चरण करीब फरवरी 2027 में जाति दर्ज करेगा, ज्यादातर देश के लिए संदर्भ तिथि 1 मार्च 2027 होगी, करीब 30 लाख गणक काम करेंगे और मोबाइल ऐप से स्वयं-गणना की खिड़की मिलेगी। 12 दिसंबर 2025 को मंजूर ₹11,718.24 करोड़ उस कोशिश की कीमत है जिसमें 2011 की गलती दोहरानी नहीं है।
जाति गणना के पक्ष में तर्क
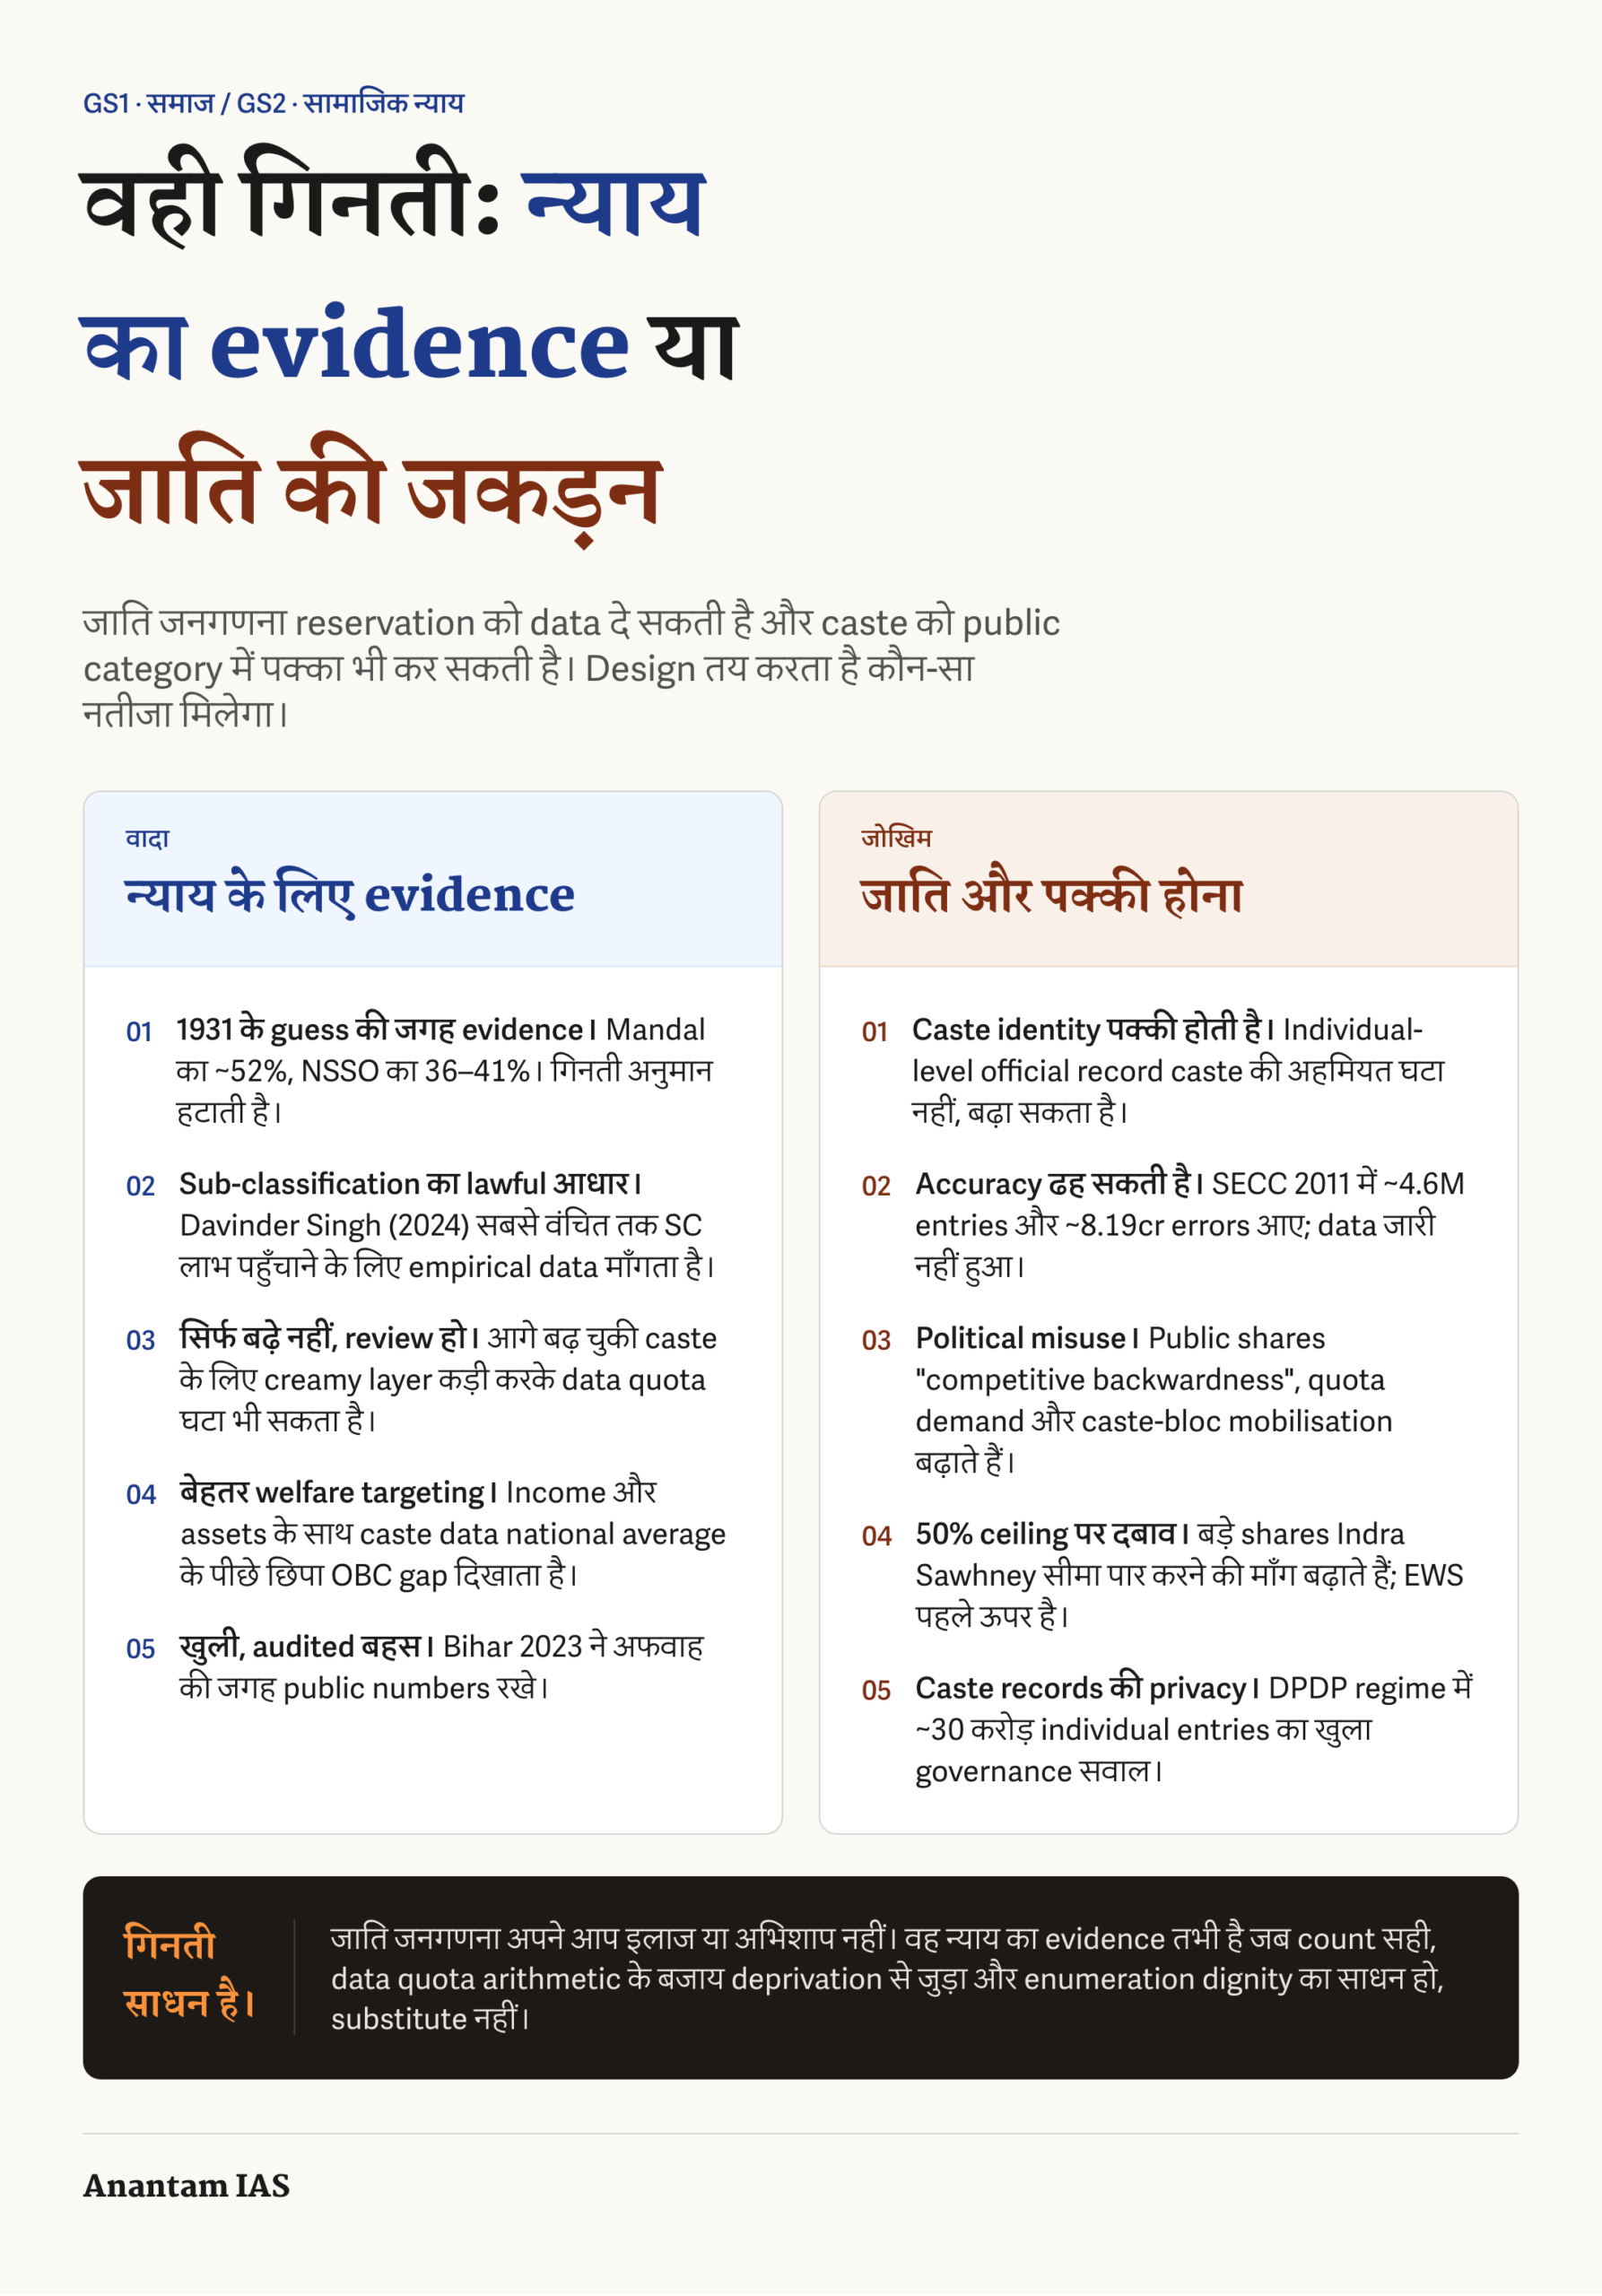
सबसे मजबूत तर्क सीधा है: जिन्हें गिनने से इनकार करते हैं, उन्हें न्याय नहीं दे सकते। करोड़ों लोगों को छूने वाला OBC कोटा गणतंत्र से भी पुरानी निकाली गई संख्या पर चल रहा है। फैलाव की जगह गिनती लाना विचारधारा नहीं, बुनियादी सांख्यिकीय सफ़ाई है।
अदालतों ने भी डेटा माँगा। Indra Sawhney v. Union of India (1992) में 9-न्यायाधीश पीठ ने 27% OBC कोटा को कायम रखते हुए पिछड़ेपन को हमेशा के लिए तय नहीं माना। पूरी व्यवस्था में मान लिया गया कि सबूत से समय-समय पर पिछड़ेपन की जाँच होगी और क्रीमी लेयर बाहर होगी ताकि बेहतर स्थिति वाले लोग लाभ न समेट लें। जो डेटा इकट्ठा ही न हो, उससे समय-समय की जाँच नहीं हो सकती। व्यवस्था तीन दशक से अँधेरे में उड़ रही है।
State of Punjab v. Davinder Singh (1 August 2024) में 7-न्यायाधीश पीठ ने 6:1 से तय किया कि राज्य SC श्रेणी में उप-वर्गीकरण कर सकते हैं, ताकि सबसे वंचित उपसमूह को अलग हिस्सा मिले। इसने 2004 के E.V. Chinnaiah फैसले को पलटा। लेकिन शर्त थी कि उप-वर्गीकरण सापेक्ष पिछड़ेपन और अपर्याप्त प्रतिनिधित्व के “मापे जा सकने वाले और अनुभवसिद्ध डेटा” पर हो। 2024 के बाद गरीब उपजातियों तक SC लाभ पहुँचाने वाला राज्य डेटा के बिना अदालती चुनौती नहीं झेल सकता। जनगणना उसे बनाने का सबसे साफ क़ानूनी साधन है।
गिनती आरक्षण बढ़ा ही नहीं, घटा भी सकती है। यदि डेटा बताए कि कुछ जातियाँ OBC लाभ की जरूरत से आगे निकल गई हैं, तो क्रीमी लेयर कड़ी करने और सूची छोटा करने का आधार बनेगा। बिहार सर्वेक्षण ने कम से कम अफवाह की जगह सार्वजनिक जाँचे गए हिस्से रखे। पक्ष “आरक्षण हमेशा” का नहीं, “अँधेरे में क़ानून बनाना बंद करें” का है।
जाति गणना के खिलाफ तर्क
जाति गिनना तटस्थ नहीं है। वह जाति के साथ कुछ करता है। संविधान निर्माता जाति-रहित समाज की ओर बढ़ना चाहते थे। डर है कि व्यक्ति-स्तर का आधिकारिक जाति रिकॉर्ड जाति को सार्वजनिक जीवन में कम नहीं, ज्यादा अहम बनाकर वही श्रेणियाँ पक्की कर देगा जिन्हें खत्म होना था। राज्य की मुहर वाली संख्या को बाद में अनदेखा नहीं किया जा सकता।
सटीकता का संकट साबित हो चुका है। SECC बुरी नीयत से नहीं, जीती-जागती जाति की क्षेत्रीय और बदलती प्रकृति से विफल हुआ। स्वयं-रिपोर्टिंग ने 4.6 मिलियन प्रविष्टियाँ बनाईं। जनगणना 2027 का डिजिटल, पहले से जाँचा गया अनुसूची इसे ठीक करने का दावा करता है, लेकिन सबूत की जिम्मेदारी नई कसरत पर है। साफ डेटा इकट्ठा और जारी होने तक “इस बार बेहतर वर्गीकृत करेंगे” उम्मीद है, नतीजा नहीं।
दूसरा जोखिम “प्रतिस्पर्धी पिछड़ापन” है। हिस्से जारी होते ही हर जाति गुट आबादी के अनुपात में कोटा माँग सकता है। बिहार का 63% OBC+EBC हिस्सा सीधा टकराव बिंदु है। कल्याण सुधारने की गिनती दलों को जाति वोटों की बोली और समूहों को जाति जुटाव का हथियार दे सकती है। डेटा इस राजनीति को बनाता नहीं, लेकिन उसे हथियार देता है।
यह 50% सीमा से भी टकराएगा। बड़े पिछड़े हिस्से सामने आए तो राज्य Indra Sawhney सीमा से ऊपर कोटा माँगेंगे। 103वें संशोधन (2019) ने SC/ST/OBC से बाहर आर्थिक रूप से कमज़ोर वर्ग (EWS) के लिए 10% कोटा जोड़ा। Janhit Abhiyan v. Union of India (7 November 2022) में 5-न्यायाधीश पीठ ने 3:2 से इसे कायम रखा और सीमा को “लचीली न होने वाली” नहीं माना। केंद्र का कुल ढाँचा कागज़ पर 60% के करीब है। बड़ा OBC गिनती सीमा को फिर अदालती अखाड़ा बनाएगी।
निजता का शांत लेकिन गंभीर जोखिम भी है। व्यक्ति-स्तर के डिजिटल जाति रिकॉर्ड में DPDP व्यवस्था के तहत सवाल हैं: डेटा किसके पास होगा, कैसे सुरक्षित रहेगा और दुरुपयोग कैसे रुकेगा? जनगणना 2027 के जाति डेटा पर अभी कोई प्रामाणिक सरकारी फैसला नहीं है। इसलिए यह तय जवाब नहीं, खुला शासन सवाल है। लेकिन जवाब 30 करोड़ जाति रिकॉर्ड बनने से पहले चाहिए।
गहरी संरचनात्मक तस्वीर
असली दरार “डेटा बनाम गरिमा” नहीं है। संविधान में खुद तनाव है: वही दस्तावेज जाति भेदभाव खत्म करने का वादा करता और जाति से न्याय देने का निर्देश देता है। अनुच्छेद 15 और 16 जाति भेदभाव रोकते हैं, फिर पिछड़े वर्गों के लिए विशेष प्रावधान की अनुमति देते हैं। संविधान जाति-अंधा बनने के लिए जाति-सचेत है। जनगणना इसी अंतर्विरोध पर बैठती है।
ईमानदार फ्रेम विरोध नहीं, क्रम है। जाति गिनना साधन है, न्याय लक्ष्य। खतरा है गिनती को उपलब्धि मान लेना। SECC ने दिखाया कि जाति डेटा का पहाड़ इकट्ठा करके भी पहुँच शून्य हो सकती है। पहुँच के बिना डेटा सामाजिक न्याय नहीं, पादटिप्पणियों वाली प्रेस विज्ञप्ति है।
गिनती और कोटा अंकगणित अलग रखें। आरक्षण व्यवस्था आबादी के हिस्सों का दर्पण नहीं थी। Indra Sawhney ने शुद्ध आनुपातिकता ठुकराई और सीमा इसलिए रखी कि आरक्षण पिछड़ेपन का साधन रहे, हर समूह की सिरगिनती नहीं। “समूह राज्य की 30% आबादी है, तो सीटें भी 30%” न्यायशास्त्र को गलत समझता है। गिनती से पिछड़ापन और उसकी गहराई पहचाननी है, वंचना डेटा के साथ; कच्चे नंबर को अपने-आप कोटा नहीं बनाना।
संघीय परत भी है। Davinder Singh के बाद उप-वर्गीकरण राज्य की शक्ति है और राज्य डेटा पर चलता है, जबकि जनगणना महारजिस्ट्रार की संघ कसरत है। एक डेटासेट अलग प्रोत्साहन वाली दो सरकारों को मिलेगा। वर्गीकरण, जारी करना और अमल पर केंद्र-राज्य रगड़ होगी, भले गिनती सही हो।
जनगणना 2027 एक साथ जाति डेटा, लोक सभा सीट परिसीमन और महिला आरक्षण चालू करती है। नारी शक्ति वंदन अधिनियम (106वाँ संशोधन, 2023) विधायी सीटों में महिलाओं के लिए एक-तिहाई आरक्षण देता है, लेकिन पहली जनगणना और उसके बाद परिसीमन पर लागू होगा। एक गिनती पर सीट पुनर्वितरण और महिलाओं के राजनीतिक आरक्षण सहित बहुत ज्यादा परिणाम लदे हैं। राजनीति सँभालने की राज्य क्षमता पूरी कसरत का छिपा चर है।
क्या किया जाना चाहिए?
न्याय देने वाली और जाति को पक्का न करने वाली जनगणना के लिए छह डिज़ाइन चुनाव चाहिए।
- खुला पाठ नहीं, पहले से कूटबद्ध और राज्य-जाँची जाति अनुसूची रखें। SECC खुले अंत वाली स्वयं-रिपोर्टिंग से 4.6 मिलियन प्रविष्टियों पर टूटा। मानक जाति और उपजाति सूची तथा सार्वजनिक वर्गीकरण तर्क सबसे बड़ा सुधार है।
- डेटा को स्वतंत्र सांख्यिकी अभिरक्षा और तय जारी तिथि दें। महारजिस्ट्रार और पारदर्शी विशेषज्ञ परत जाँचें, लेकिन सख्त प्रकाशन समय-सीमा हो ताकि जाँच दफनाने का तंत्र न बने। हमेशा रोका डेटा बेकार डेटा है।
- जाति सूक्ष्म-डेटा पर कड़े निजता नियम हों। केवल योग जारी करें, पहुँच बंद रखें और गणना से पहले दोबारा पहचान व राजनीतिक दुरुपयोग की सीमा DPDP Act के अनुरूप लिखें। 30 करोड़ रिकॉर्ड को निशाने की तरह सुरक्षित करें।
- गिनती को वंचना से जोड़ें, केवल कोटा से नहीं। जाति के साथ शिक्षा, स्वास्थ्य, संपत्ति और पेशा डेटा रखें ताकि लक्षित कल्याण तथा बेहतर क्रीमी-लेयर छँटाई हो। जो संख्या बच्चे के स्कूल या परिवार के क्लिनिक को न बदले, वह विफल है।
- समय-समय की जाँच तय करें। Indra Sawhney तर्क के अनुसार ताज़ा डेटा पर OBC सूचियों की हर चक्र में जाँच हो। लाभ अभी बाहर पड़े लोगों की ओर और आगे बढ़ चुकी जाति से दूर जाए।
- गिनती को सीमा की लड़ाई से अलग रखें। गणना तथ्य जुटाना है। 50% सीमा अलग सबूत-आधारित संवैधानिक न्यायनिर्णय का विषय रहे। कच्ची आबादी हिस्से कोटा न तय करे।
ये छह कदम जनगणना को न्याय का सबूत बनाते हैं। इन्हें छोड़ें तो 4.6-मिलियन-प्रविष्टि गड़बड़ी या कोटा नीलामी मिलेगी। नतीजा गिनने के फैसले से ज्यादा डिज़ाइन तय करता है।
मुख्य परीक्षा के उत्तर में इसका इस्तेमाल
यह GS1 और GS2 दोनों में सीधा बैठता है। GS1 में भारतीय समाज, सामाजिक संस्था के रूप में जाति और गिनती का सामाजिक ताने-बाने पर असर। GS2 में सामाजिक न्याय, कमज़ोर वर्गों के लिए आरक्षण व कल्याण, डेटा-आधारित शासन और संघवाद।
संभावित प्रश्न:
- जाति जनगणना आरक्षण को सबूत दे सकती है, लेकिन जाति को सार्वजनिक श्रेणी के रूप में पक्का करने का जोखिम भी है। जनगणना 2027 के संदर्भ में आलोचनात्मक परीक्षण कीजिए।
- आरक्षण न्यायशास्त्र मानता है कि पिछड़ेपन को डेटा से जाँचा जाएगा। Mandal से Davinder Singh तक के ढाँचे में जाति गणना का रिश्ता समझाइए।
- मूल्यांकन कीजिए कि जाति जनगणना जाति-रहित समाज की संवैधानिक दृष्टि को मज़बूत करती है या उस पर दबाव डालती है।
उत्तर में लिखने लायक आँकड़े:
- 1931 आखिरी पूरी जाति जनगणना; जनगणना 2027 इसे 96 साल बाद लौटाती है।
- ₹11,718.24 करोड़, 12 दिसंबर 2025 को मंत्रिमंडल-मंजूर जनगणना 2027 बजट।
- OBC अनुमान: Mandal का करीब 52% बनाम NSSO का 36-41%, डेटा खालीपन का प्रमाण।
- SECC 2011 में 4.6 मिलियन जाति प्रविष्टियाँ, करीब 8.19 करोड़ गलतियाँ और 1.46 करोड़ अनसुलझी।
- बिहार 2023 में OBC+EBC 63.13%, जिसमें EBC 36.01% और OBC 27.12%; यह राज्य आँकड़ा है, राष्ट्रीय नहीं।
- Indra Sawhney (1992) की 50% सीमा; Janhit Abhiyan (2022) में 3:2 से कायम 10% EWS उसके ऊपर बैठता है।
- Davinder Singh (2024) में 6:1 से अनुभवसिद्ध डेटा पर SC उप-वर्गीकरण की अनुमति।
- 106वें संशोधन के तहत 33% महिला आरक्षण जनगणना और परिसीमन पर निर्भर।
मुख्य शब्द: जाति गणना, सबूत-आधारित नीति, क्रीमी लेयर, उप-वर्गीकरण, 50% सीमा, आनुपातिकता, प्रतिस्पर्धी पिछड़ापन, जाति-रहित समाज, संघवाद और डेटा-चालित शासन।
पाठ्यक्रम से जोड़: भारतीय समाज और विविधता; कमज़ोर वर्गों की सुरक्षा नीतियाँ; अनुच्छेद 15, 16, 341 और 342; महारजिस्ट्रार और NCBC; शासन, पारदर्शिता और नागरिक डेटा।
संतुलित निष्कर्ष: जाति जनगणना अपने आप में न इलाज है, न अभिशाप। वह न्याय का सबूत तभी बनेगी जब गिनती सही हो, डेटा कोटा अंकगणित के बजाय वंचना से जुड़ा हो और राज्य गणना को गरिमा का साधन माने, उसका विकल्प नहीं।
उत्तर कैसे बनाएँ?
परिभाषा नहीं, अंतर्विरोध से शुरू करें: संविधान जाति खत्म करने के लिए जाति का इस्तेमाल करता है और जनगणना इसी जोड़ पर है। दूसरी पंक्ति में OBC या जाति जनगणना की परिभाषा दें। फिर जल्दी लेकिन सीमित डेटा रखें: 36-52% अनुमान फैलाव, SECC की 4.6 मिलियन प्रविष्टियाँ और बिहार का 63%। हर संख्या के बाद उसका मतलब लिखें।
जिस पक्ष को नहीं मानते, उसे भी मजबूती से रखें। जनगणना समर्थक हों तो पक्का होने और सटीकता के जोखिम साफ मानें। सावधान हों तो 1931 के अंदाज़े पर नीति चलाना असमर्थनीय मानें। सुधारों को जाँची अनुसूची, स्वतंत्र अभिरक्षा और समय-सीमा, निजता, वंचना जोड़, समय-समय की जाँच और सीमा से अलगाव में समूह करें। निष्कर्ष में कहें: गिनती उपलब्धि नहीं, पहुँच है।
आम गलतियाँ
- जनगणना को अपने आप अच्छा या बुरा न कहें। डिज़ाइन परिणाम तय करता है।
- बिहार के 63% को भारत पर न लगाएँ। यह एक-राज्य सर्वेक्षण है। ऐसा विस्तार वही Mandal गलती दोहराता है।
- आबादी हिस्से को कोटा न समझें। Indra Sawhney ने आनुपातिक आरक्षण ठुकराई।
- SECC 2011 की नाकामी न छोड़ें। पिछली जाति गिनती का जारी न होना सबसे जरूरी मिसाल है।
- लागत उठाने वाले लोगों को न भूलें। डेटा जिस पिछड़े परिवार तक पहुँचना है और खराब गिनती जिसकी पहचान पक्की कर सकती है, दोनों का नाम लें।
उत्तर की छोटी रीढ़
- परिचय: संवैधानिक अंतर्विरोध, अगली पंक्ति में जाति जनगणना और OBC की परिभाषा।
- सबूत: OBC अनुमान फैलाव, SECC ढहना और बिहार हिस्सा, हर एक के साथ मतलब।
- तर्क: सबूत-आधारित आरक्षण का पक्ष, फिर पक्का होने और सटीकता का पक्ष।
- संरचनात्मक निदान: अनुच्छेद 15 और 16 में जाति-अंधा बनने के लिए जाति-सचेत राज्य; गिनती साधन है, लक्ष्य नहीं।
- आगे का रास्ता: महारजिस्ट्रार, राज्य, NCBC और संसद के कर्ताओं के साथ पाँच या छह डिज़ाइन चुनाव।
- निष्कर्ष: सवाल के ठीक शब्दों में संतुलित निष्कर्ष।
आरेख या फ़्लोचार्ट का विचार
15-अंक वाले में कारण श्रृंखला बनाएँ: 1931 अंदाज़ा → फैलाव पर नीति → अदालतें डेटा माँगती हैं, Indra Sawhney और Davinder Singh → जाति जनगणना → डिज़ाइन के अनुसार सबूत-आधारित कल्याण या पक्का होना। 10-अंक वाले में “वादा” और “जोखिम” की दो-स्तंभ तालिका बेहतर है। वादे में सबूत, क़ानूनी उप-वर्गीकरण और लक्ष्यीकरण; जोखिम में पक्का होना, वर्गीकरण ढहना और सीमा दबाव।
नैतिकता और शासन का पक्ष
गहरा सवाल सांख्यिकीय नहीं है: क्या राज्य जाति नुकसान खत्म करने के लिए जाति पहचान इस्तेमाल कर सकता है, बिना उसे स्थायी बनाए? यह अवसर की समानता और समूह फ़र्क़ की मान्यता की असली दुविधा है। सिद्धांत को डिज़ाइन में बदलें: केवल योग जारी करना, गणना से पहले निजता नियम, वंचना से जुड़ा डेटा और समय-समय की जाँच।
काम की पंक्ति है: “कसरत का लक्ष्य जायज़ है, लेकिन उसकी वैधता सटीकता, पारदर्शिता और मिले सबूत पर अमल की क्षमता पर निर्भर है।”
आँकड़ों को यांत्रिक बनाए बिना कैसे लिखें?
तीन समझाई संख्या दस बिखरी संख्याओं से बेहतर हैं। डेटा खालीपन के लिए 36-52% OBC फैलाव, चेतावनी के लिए SECC की 4.6 मिलियन प्रविष्टियाँ और राजनीति के लिए बिहार का 63% लें। हर आँकड़े के बाद “इसका मतलब” या “नीति मतलब” लिखें।
अंत में पूछें: थका परीक्षक एक बार में समझ सकता है? छोटा परिचय, शुरुआती डेटा, दो साफ पक्ष और समूहित आगे का रास्ता रखें। UPSC में साफ़पन ही गहराई को दिखने लायक बनाती है।
सामान्य प्रश्न
1931 से 2027 के बीच जाति क्यों नहीं गिनी गई?
1951 और उसके बाद की जनगणना ने केवल अनुच्छेद 341 और 342 के SC व ST गिने और पूरी जाति गणना छोड़ी। स्वतंत्र भारत मानता था कि सभी जातियाँ गिनना जाति मिटाने के बजाय पक्की करेगा। इसलिए OBC नीति दशकों तक 1931 से निकाले करीब 52% Mandal अनुमान पर चली, जनगणना 2027 तक कोई नया राष्ट्रीय गिनती नहीं हुआ।
SECC 2011 के जाति डेटा में क्या गलत हुआ?
खुले अंत वाली स्वयं-रिपोर्टिंग से जाति, उपजाति, उपनाम और कबीले की करीब 4.6 मिलियन प्रविष्टियाँ बनीं। करीब 8.19 करोड़ गलतियाँ मिलीं और 1.46 करोड़ अनसुलझी रहीं। जाति डेटा इस्तेमाल के लायक नहीं माना गया और कभी जारी नहीं हुआ। 2021 में सर्वोच्च न्यायालय ने प्रकाशन का आदेश देने से इनकार किया।
क्या जाति जनगणना से आरक्षण अपने आप 50% पार होगा?
नहीं। Indra Sawhney (1992) ने 50% सीमा और शुद्ध आनुपातिक आरक्षण के खिलाफ नियम रखा, इसलिए आबादी हिस्सा अपने आप कोटा नहीं बनता। लेकिन बिहार जैसे 63% पिछड़े हिस्से कोटा बढ़ाने की राजनीतिक माँग बढ़ाएँगे। Janhit Abhiyan (2022) में कायम 10% EWS पहले ही 50% से ऊपर बैठता है, इसलिए सीमा पूरी तरह तय नहीं है।
जनगणना 2027 महिलाओं के आरक्षण से कैसे जुड़ी है?
नारी शक्ति वंदन अधिनियम (106वाँ संशोधन, 2023) विधायी सीटों में एक-तिहाई महिला आरक्षण देता है, लेकिन पहली जनगणना और बाद के परिसीमन के बाद लागू होगा। इसलिए जनगणना 2027 एक साथ जाति डेटा, सीट परिसीमन और महिलाओं का राजनीतिक आरक्षण चालू करती है।